Я программирую с 1999 года, а с ИИ-агентами, в последнее время, работаю каждый день. Но если честно спросить себя «как эта штука устроена внутри», ответ выходит туманный. Решил разобраться и по порядку записывать то, что понял, — короткими уроками, по одной мысли. Этот — первый.
Обычная программа и нейросеть
Обычную программу пишет человек: «если в письме есть слово «выигрыш» — это спам». Правила придумывает программист, и программа умеет ровно то, что он придумал.
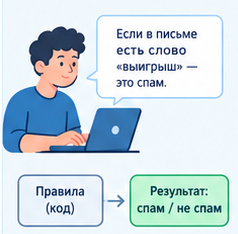
Нейросеть правил не получает. Ей показывают примеры: вот тысяча писем со спамом, вот тысяча нормальных. Внутри у неё — огромный пульт с ручками-крутилками, их называют параметрами или весами. Сначала ручки стоят как попало, и нейросеть угадывает плохо. После каждой ошибки специальная процедура чуть подкручивает все ручки так, чтобы в следующий раз ошибиться меньше. Миллионы примеров спустя ручки стоят так, что нейросеть отличает спам лучше, чем правила, придуманные вручную.

Это и называется обучением. А то, что получилось в итоге, — набор чисел, в которые выставлены ручки, — называют моделью.
Ручек бывает очень много. У GPT-3, модели 2020 года, их было 175 миллиардов. Какая ручка за что отвечает, не знает никто, включая создателей. Это важно: нейросеть не программируют, её выращивают.
Языковая модель: угадай, что дальше
Языковая модель (по-английски LLM, large language model) — нейросеть, которую учили одной-единственной задаче: по началу текста угадать следующий кусочек.
«Жили-были дед да …» — дальше почти наверняка «баба». Модели показали триллионы слов — книги, сайты, код, форумы, — и для каждого места в тексте она пыталась угадать продолжение. Ошиблась — ручки подкрутили.
Самое удивительное: чтобы хорошо угадывать продолжение, модели пришлось «понять» очень многое. Чтобы продолжить «столица Франции — …», нужно знать столицу. Чтобы продолжить программу на Python — понимать Python. Никто не учил её отдельно географии и программированию: всё это вылезло из одной задачи «угадай дальше», когда текста и ручек стало достаточно много.
Откуда берётся собеседник
Модель, которая просто продолжает текст, на вопрос «как сварить борщ?» может ответить ещё тремя вопросами — потому что в интернете за вопросом часто следует другой вопрос. Поэтому её доучивают на примерах диалогов: вопрос — полезный ответ. После этого она продолжает текст уже «в роли помощника».
ChatGPT, Claude, GigaChat, Алиса — это такие доученные модели плюс программа-чат вокруг них. Сама модель по-прежнему делает одно: дописывает следующий кусочек, потом ещё один, потом ещё — пока ответ не закончится.
Попробуйте сами
Откройте на телефоне заметки и наберите «Привет, как». Над клавиатурой появятся подсказки следующего слова. Нажимайте среднюю подсказку десять раз подряд и посмотрите, что получится.

Это крошечная языковая модель: она тоже угадывает следующее слово, только видит одно-два предыдущих и училась на ваших сообщениях. Большая модель делает то же самое, но видит десятки страниц текста сразу и училась на значительной части интернета. Разница в масштабе такая, что количество перешло в качество.
Что запомнить
- Нейросеть не программируют правилами, её обучают на примерах, подкручивая миллиарды параметров.
- Языковая модель умеет одно — угадывать продолжение текста. Ответы, код и переводы — всё это «продолжение».
- Модель не ищет ответ в базе знаний, она пишет правдоподобное продолжение. Обычно правдоподобное совпадает с правдой, но не всегда — об этом будет отдельный урок.
В следующем уроке — токены: почему модель на самом деле читает не словами и что такое «контекст», о котором все говорят.
Если что-то осталось непонятным — спрашивайте в комментариях, вопросы попадут в следующие уроки.