Утром 2 ноября 2026 года мои сайты пропали из интернета. Не «тормозят» и не «ошибка 500», а пропали целиком: браузер говорил, что такого адреса нет. Лежал хостинг Beget, на котором живут lexium.ru, мой дневник alexcube.ru и ещё с десяток сайтов. Вместе с хостингом легли и его DNS-серверы, так что домены просто перестали существовать.
Сначала я сделал то, что делают все: стал ждать, когда наконец починят. Обычно это делается быстро. Но не в этот раз. Уже днём сообразил, что ждать можно непозволительно долго, и начал действовать.
За первые сутки получилась целая цепочка: сторож, который следит за хостингом, переключение доменов на резервный сервер, заглушка в виде старого ЭЛТ-монитора с бегущей строкой, рабочие инструменты сайта прямо на заглушке и, под конец, ревизия безопасности самого резервного сервера, на который вдруг попёр трафик.
Это хроника, а не инструкция «как правильно». С граблями, ошибками и одной ложной тревогой от нейронки. Работал я в паре с ИИ-агентом, и это тоже часть истории.
Час первый: ждём

Первым делом я завёл сторожа. Это скрипт на Python, который живёт на моём домашнем сервере и раз в 20 минут стучится на мои сайты и в панель самого хостинга. Сайт считается упавшим после двух провалов подряд. Тогда сторож пишет мне в мессенджер, а когда сайт поднимется, напишет ещё раз и сообщит, сколько он пролежал.
Первая же запись в журнале сторожа выглядела так:
2026-11-02 10:22:13 lexium.ru FAIL DNS не резолвится
2026-11-02 10:22:13 alexcube.ru FAIL DNS не резолвится
…
Одна полезная мелочь: сторож отличает «лежит хостинг» от «отвалился мой собственный интернет». Если одновременно не отвечают ya.ru, api.vk.com и google.com, значит, проблема на моей стороне. Тогда прогон пропускается и в счёт провалов не идёт. Иначе при каждом сбое домашнего провайдера я получал бы панические сообщения про все сайты сразу.
Час второй: план «Б» через регистратора

Домены у меня куплены не у хостера, а у отдельного регистратора. Это и спасло. У регистратора есть свои DNS-серверы и API, через который можно сменить NS (серверы имён) домена. Схема получилась такая:
- в обычное время NS доменов смотрят на хостинг, там же зона и почта;
- если сайт лежит две проверки подряд, сторож через API регистратора переводит NS на его серверы. Там лежит запасная зона: сайт ведёт на мой резервный сервер, почта по-прежнему на хостинг;
- когда хостинг оживает, сторож возвращает NS обратно.
Переключатель включается одним файлом-флагом. Без него сторож только сообщает о проблеме, но ничего не трогает: автоматике, которая сама перекидывает DNS, я доверяю не сразу.
No access to manage zone. Поэтому сторож делает наоборот: сначала переключает NS, потом заполняет зону. Если заполнить не вышло, повторяет в каждом прогоне, пока сайт лежит.dig и запоминает. При следующей аварии запасная зона заполнится ими. В этот раз пришлось обойтись настройками хостера по умолчанию. Т.е. почту я временно потерял.Первое переключение я сделал руками около 11:50: доверять автоматике, которая ни разу не запускалась, в первый же день не стал. Дальше ждём: делегирование в зоне .ru кэшируется, и новые NS расходятся по интернету до нескольких часов.
Грабли №4: Let’s Encrypt банит за нетерпение
Сайт на резервном сервере без HTTPS — это предупреждение браузера на весь экран. Значит, нужен сертификат Let’s Encrypt. А чтобы его выдать, Let’s Encrypt должен найти домен на моём сервере, то есть новые NS должны уже разойтись.
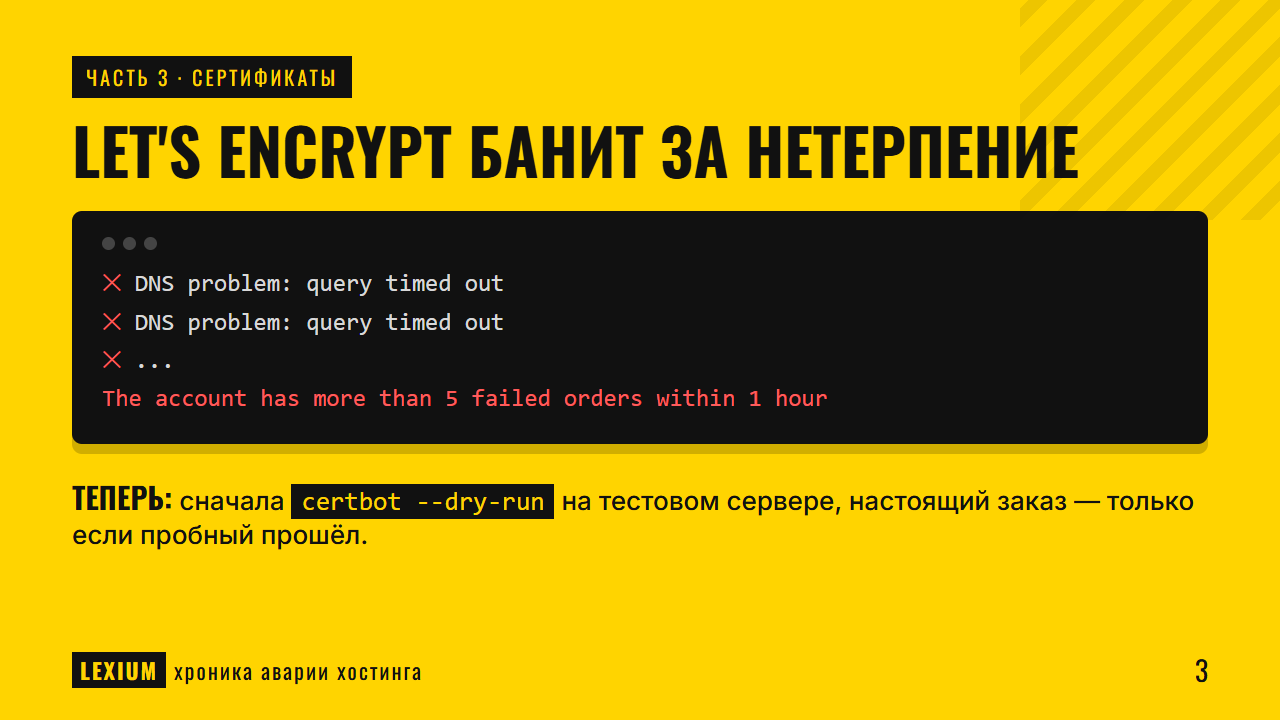
Я поторопился. Несколько заказов подряд упали с DNS problem: query timed out, и следующий ответ был уже такой:
The account has more than 5 failed orders within 1 hourПять неудачных заказов за час, и аккаунт блокируется. Хуже того, ACME-аккаунт на сервере общий для всех сайтов, так что блокировка задела бы и продление сертификатов у остальных.
Теперь перед каждым боевым заказом сторож делает пробный на тестовом сервере Let’s Encrypt (certbot --dry-run). Тестовый сервер не считает провалы против боевого лимита. Боевой заказ уходит, только если пробный прошёл. Сертификаты выпустились около 12:35, когда DNS наконец разошёлся.
Заглушка: псевдоновостной эфир на ЭЛТ-мониторе
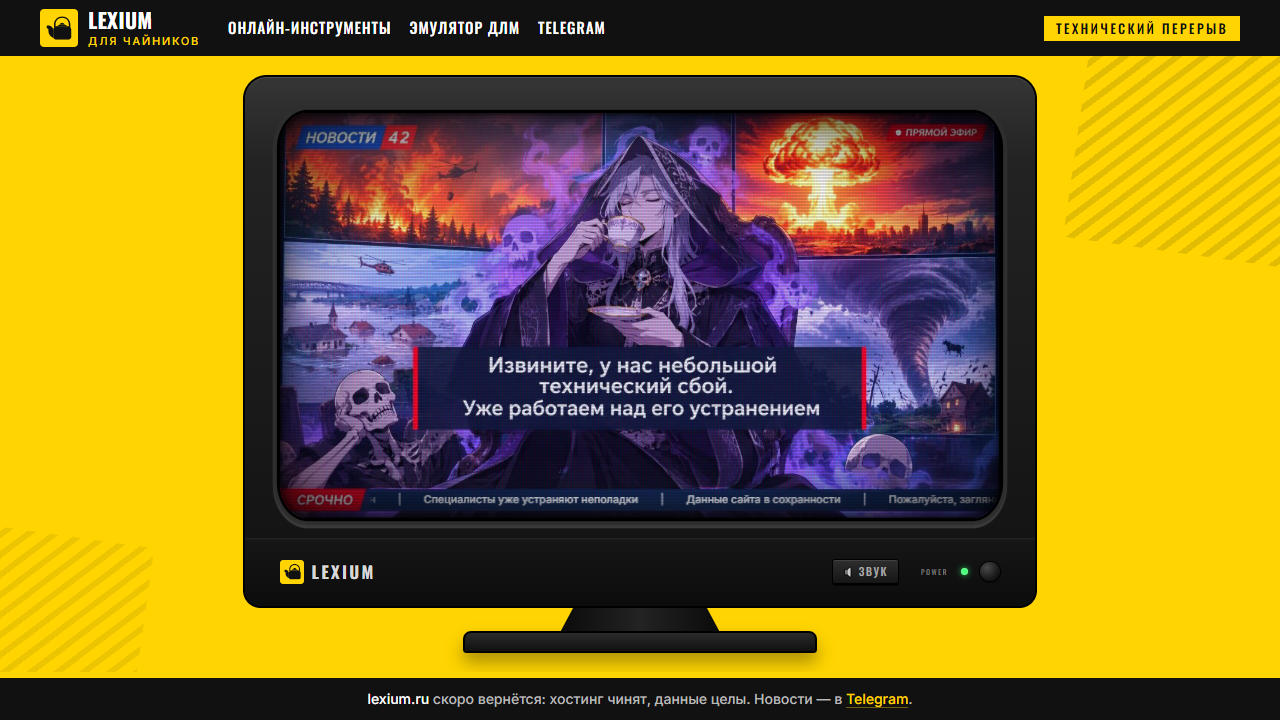
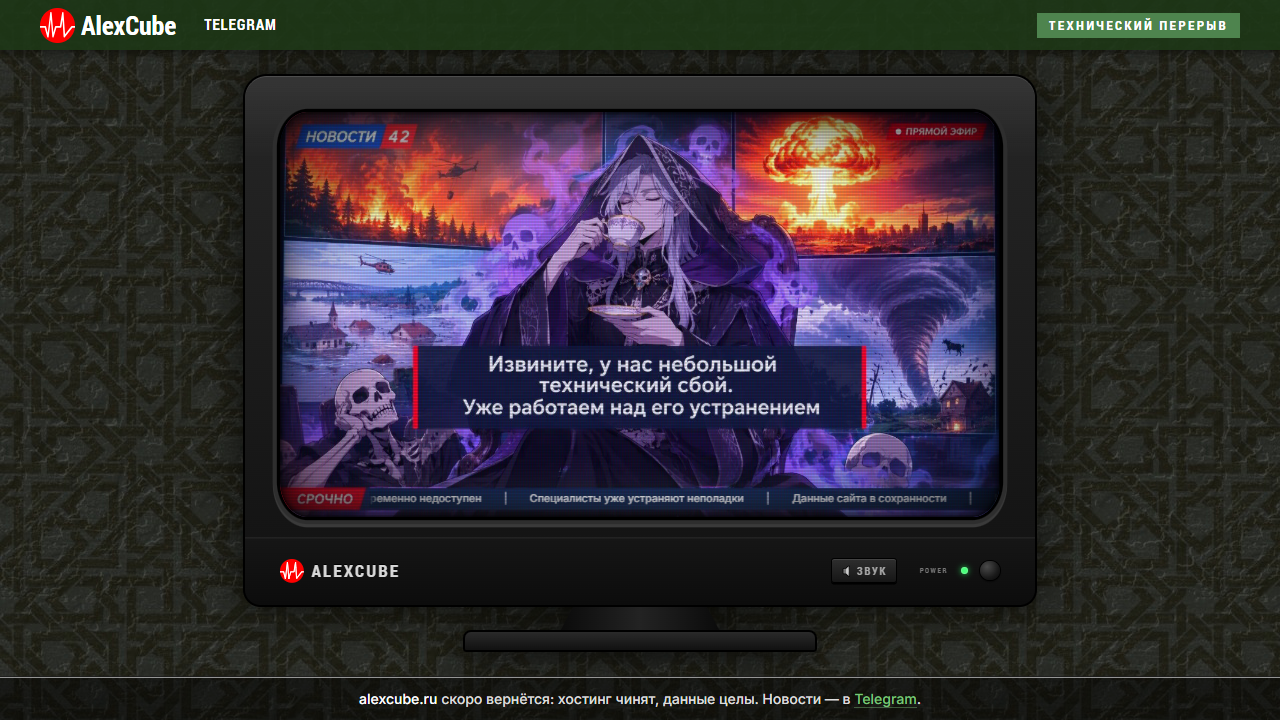
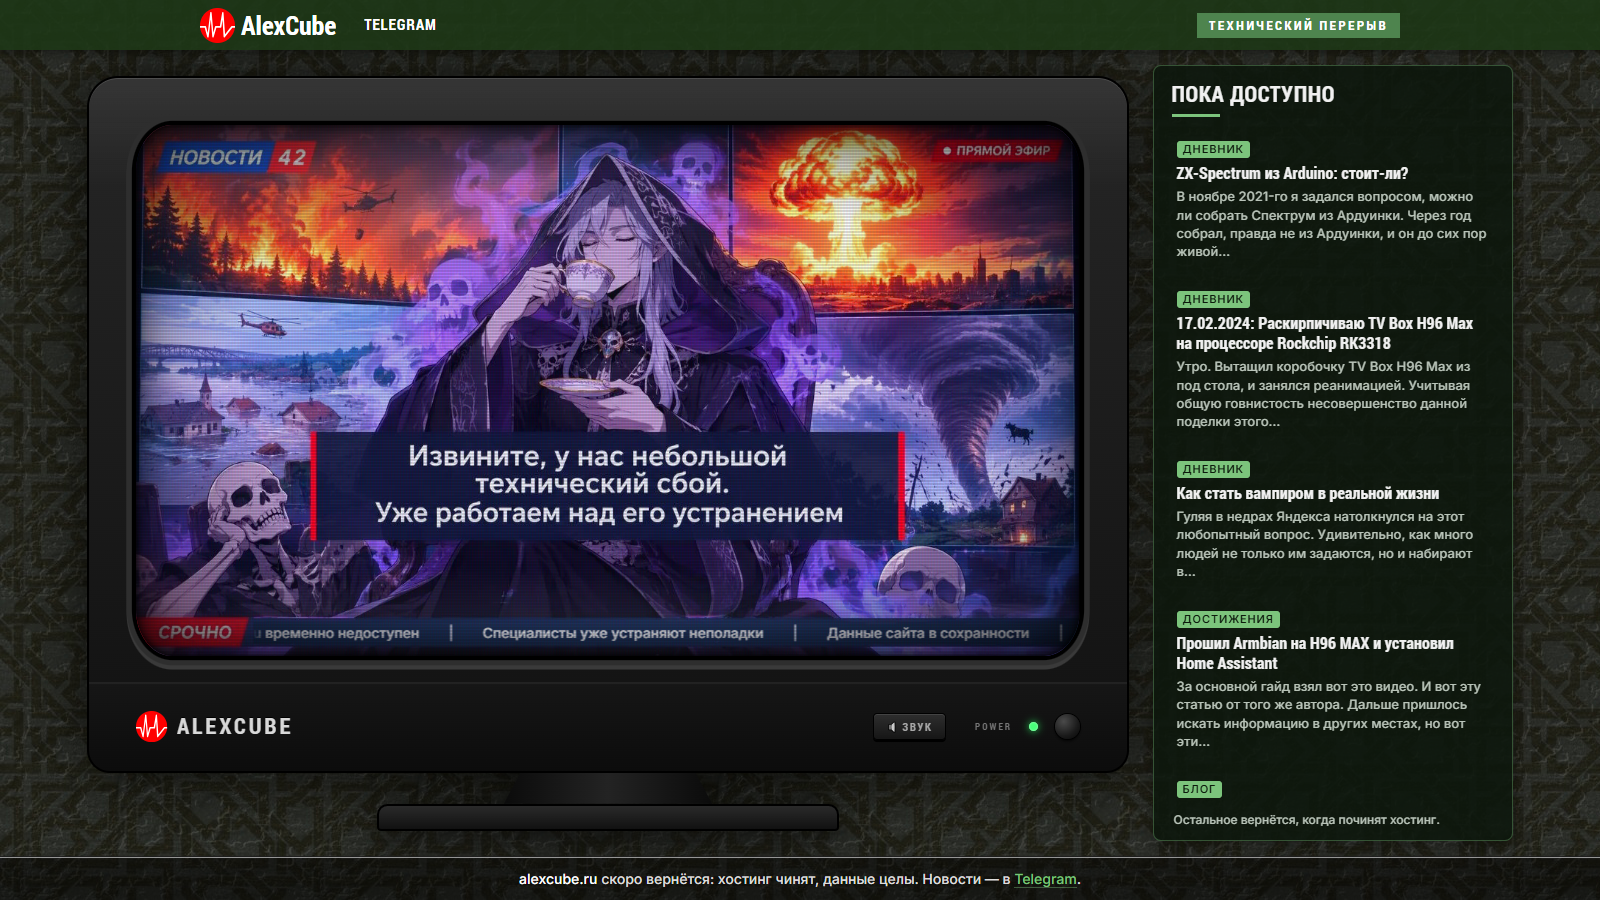
Пустая страница «сайт временно недоступен» — скучно. У меня была картинка с новостной студией и пустой бегущей строкой, и из неё получилась заглушка-«прямой эфир».
Как она устроена:
- картинка эфира показана на старом ЭЛТ-мониторе: скруглённый кинескоп, строки развёртки, маска RGB, бегущая полоса и блик. При загрузке монитор один раз включается «из точки», как настоящий;
- центральная плашка периодически дёргается гличами, а монитор в такт дрожит, будто сбилась синхронизация;
- по полосе справа от «СРОЧНО» бежит текст о сбое;
- вокруг монитора — шапка, поле и подвал в стиле самого сайта. lexium.ru получил жёлтое поле и шрифт Oswald, а дневник alexcube.ru — тёмный узор и свою зелёную плашку. Шаблон один, оформление выбирается атрибутом
data-site; - звук генерируется прямо в браузере через Web Audio: гул, вентилятор, писк, щелчки диска, белый шум и помехи синхронно с гличами. Ни одного аудиофайла.
Главная техническая деталь заглушки не видна глазу: любой адрес отдаёт её с кодом 503 и заголовком Retry-After: 1800. Так поисковики понимают, что это временный сбой, и не выкидывают страницы из индекса. Если бы заглушка отдавала 200, через пару дней поиск решил бы, что все мои статьи превратились в одну страницу про аварию.
На заглушке стоит тот же счётчик Метрики, что и на сайте. Каждый показ отправляет цель «hosting_down», а включение звука — «stub_sound_on». Так я вижу не только сколько людей упёрлись в аварию, но и сколько из них решили послушать эфир.
Ночь: инструменты прямо на заглушке
К вечеру хостинг так и не ожил, и стало обидно: люди приходят на сайт за конкретными онлайн-инструментами, а получают эфир, пусть и красивый. Эти инструменты — статические страницы с JavaScript, им сервер почти не нужен. Значит, их можно поднять прямо на резервном сервере.
Ночью на «заглушке» заработали:
- эмулятор ДЛМ по своему настоящему адресу
/dlm/; - онлайн-инструменты: каталог и 17 страниц инструментов, каждая по своему настоящему адресу.
Страницы инструментов собирает скрипт на Python. Он берёт стили, шапку и подключаемые файлы из темы сайта, тексты — из дампа базы и из исходников свежих постов, а шорткоды доната и рекламы выкидывает. Сам же скрипт дописывает правила для веб-сервера: эти адреса отдают 200, всё остальное по-прежнему 503 с эфиром. В меню заглушки появились пункты «Онлайн-инструменты», «Эмулятор ДЛМ» и Telegram.
У страниц инструментов стоит canonical на себя и нет noindex: для поисковика это та же страница по тому же адресу, что и до аварии.

Утро: а резервный сервер защищён вообще?

Ночью на мой домашний сервер пошёл трафик с двух сайтов. До этого он жил тихо и служил для домашних дел. Утром я задал агенту вопрос, который надо было задать раньше: «Проверь, хорошо ли сервер защищён от взлома».
Нашлось вот что:
- Обновления. 450 неустановленных пакетов, ядро от апреля, сервер не перезагружался 110 дней. Автообновлений не было.
- Открытые порты, которые никому не нужны. FTP смотрел в интернет, хотя на сервере не было ни одного FTP-аккаунта. За 30 дней на него заходили 204 раза с чужих адресов: сканеры просто проверяли, что тут есть. Ещё два проброса на роутере остались от установки панели управления и тоже были не нужны снаружи.
- SSH оказался в порядке: вход только по ключу, пароль выключен, fail2ban банит на неделю после пяти неудачных попыток. За сутки подборщики сделали больше 400 попыток, всего fail2ban забанил 934 адреса. Ни одна не прошла, потому что пароля просто нет.
- Права 777 на папках одного из сайтов. Если взломают сам сайт, писать в эти папки сможет кто угодно.

Дальше по порядку. Лишние пробросы на роутере я снял, FTP выключил, права 777 заменил на 755 и 644, лишние правила в файрволе удалил. И сразу наступил на следующие грабли.
Про двухфакторку меня смутило одно: не зависит ли вход от стороннего сервиса, который могут положить так же, как хостинг. Не зависит. Это TOTP, коды по времени: секрет один раз передаётся QR-кодом, дальше телефон и сервер считают коды каждый сам, из секрета и текущего времени. Приложение работает даже в авиарежиме, никакой Google в проверке не участвует. Нужны только точные часы, а сервер их сверяет по NTP, расхождение — доли миллисекунды. На случай потери телефона рядом лежит батник, который отключает двухфакторку по SSH.
Грабли №9: настройка SSH, которая не работает. Чтобы выключить ненужный X11Forwarding, логично написать X11Forwarding no в /etc/ssh/sshd_config. На многих современных дистрибутивах это не сработает: в самом начале этого файла подключается каталог sshd_config.d/, а в нём один из системных файлов уже говорит yes. У sshd побеждает первое найденное значение. Правильно — положить настройку в файл, который в каталоге стоит раньше:
echo 'X11Forwarding no' > /etc/ssh/sshd_config.d/00-hardening.conf
sshd -t && systemctl reload sshd
sshd -T | grep -i x11forwarding
Последняя команда показывает итоговое значение, а не то, что написано в файле.
Потом обновил систему: 450 пакетов, новое ядро, перезагрузка. Перед перезагрузкой проверил, что все нужные службы стоят в автозапуске, и записал список открытых портов, чтобы сравнить после. Сервер вернулся через 40 секунд, все службы поднялись сами, порты совпали.
И последнее: чтобы сервер снова не отстал на полгода, он теперь раз в неделю сам скачивает обновления, но не ставит их, а пишет мне в мессенджер, сколько их и есть ли среди них важные: ядро, OpenSSH, OpenSSL, sudo. Ставлю я сам, когда удобно. Туда же теперь пишет и сторож сертификатов: он и раньше говорил о проблемах вслух голосом, но голос слышно только дома.
День второй: статьи вместо эфира

Хостинг лежал уже вторые сутки, и стало ясно: если и дальше отдавать на каждый адрес «прямой эфир» с кодом 503, поисковики рано или поздно начнут выкидывать страницы, а читатели привыкнут, что сайта нет. Инструменты уже работали. Пора было возвращать статьи, но не все, а те, ради которых люди приходят.
Список я взял из Метрики: страницы входа за 90 дней до аварии, только люди, без роботов. Вышло по семь страниц на сайт. На lexium.ru это статьи про профили Яндекс Браузера, G-code, экспресс-панель Оперы, Let’s Encrypt и Speed Dial, плюс уже работавшие инструменты. На дневнике alexcube.ru это ZX Spectrum из Ардуино, TV Box, Armbian, Home Assistant на Debian, Битрикс и два поста про вампиров. «Как стать вампиром в реальной жизни» — самый читаемый текст дневника, его нельзя было оставлять в эфире.
Откуда брать тексты, если хостинг недоступен:
- lexium.ru — из дампа базы недельной давности и из исходников свежих постов, которые я храню локально. Скрипт собирает страницы в теме сайта по тем же адресам, что и до аварии.
- alexcube.ru — дампа нет. Посты про вампиров когда-то переехали с lexium, поэтому нашлись в его дампе. Остальные тексты и даже обёртку страницы (меню, крошки, подвал) скрипт взял из Веб-архива (Wayback Machine).
- Картинки тоже из Веб-архива. Бэкапа картинок у меня не оказалось, а архив сохранил далеко не всё, особенно после 2022 года. На месте пропавшей картинки стоит рамка «Скриншот не сохранился. Вернётся вместе с сайтом» — честнее, чем битая иконка.
Ещё двух страниц дневника в архиве не нашлось вовсе, они так и остались в «эфире». А около 419 постов, которые раньше переехали с lexium на alexcube, на зеркале lexium получили те же 301-редиректы, что и на настоящем сайте.
Последний штрих — лента «Пока доступно». Человек, который попал на эфир, не знает, что часть сайта работает. Теперь справа от телевизора стоит прямоугольник со списком живых страниц: рубрика, заголовок и начало текста, список листается. На телефоне он стоит под телевизором. Каждая сборка зеркала сама пишет свой кусочек списка, а скрипт выкладки вставляет его в шаблон заглушки. Лента видна и на главной, и на любом адресе, который пока отдаёт эфир.
День третий: ожил, упал, ожил
Утром 4 ноября, в 07:47, сторож увидел, что сайты на хостинге отвечают, и сам вернул NS доменов на Beget. Радовался я недолго: через час хостинг снова лёг. В 09:07 сторож так же сам перевёл домены обратно на резервный сервер. Это было первое переключение, которое я не трогал руками: флаг стоял, две проверки подряд провалились, NS ушли к регистратору, зона заполнилась, сертификаты уже были. Заглушка и зеркало статей включились без меня.
Окончательно хостинг ожил в 15:27, и сторож вернул домены во второй раз. Всего сайты пролежали около 53 часов, с утра понедельника до середины среды.
Первым делом — бэкап
Пока хостинг лежал, выяснилось неприятное: свежего полного бэкапа у меня не было. Был дамп базы lexium недельной давности, а картинки пришлось собирать по Веб-архиву. Поэтому, как только хостинг ожил, первым делом я снял всё: файлы всех сайтов аккаунта и все базы, больше 11 ГБ.
Ничего не сохранялось на самом хостинге. Если положить дамп базы в папку сайта, его может скачать кто угодно, кто угадает имя файла. Поэтому дамп сразу сжимается и идёт потоком по SSH ко мне домой, а на сервере не остаётся ни одного файла. Пароль от базы тоже не путешествует: скрипт прочитал его из конфига сайта прямо на сервере. Сайт соседнего проекта весит больше 100 ГБ, его папки качаются частями и по одному потоку: хостинг после аварии и так еле дышит.
Access denied. Вторую я делать не стал: 1 ноября, накануне аварии, пять неудачных попыток по FTP закончились баном моего домашнего IP на всём хостинге. Рабочий пароль нашёлся в менеджере сайтов FileZilla, которой я обычно заливаю файлы. Правило теперь такое: отказ во входе — стоп, сначала разобраться, потом пробовать.</dev/null. Мораль та же, что с ложной тревогой: отчёт «всё готово» стоит сверить с тем, что лежит на диске.У одного проекта база живёт не на самом хостинге, а в облаке того же провайдера, и облако на момент публикации ещё не починили. За ним теперь следит отдельный сторож. Раз в 20 минут он проверяет, открыт ли порт базы, и даже не пытается войти. Как только порт откроется, придёт сообщение, а сторож выключится сам.
Итог
Было: все сайты на одном хостинге, DNS у него же, резервный сервер без обновлений с апреля и с FTP наружу. Стало: сторож, который сам переключает домены на резервный сервер и обратно, заглушка, которая не роняет сайт в поиске, рабочие инструменты и самые читаемые статьи на время аварии, сервер, который сам напоминает себя обновить, и полный бэкап всех сайтов у меня дома.
Главный урок шире этой истории: план «Б» надо готовить, пока план «А» работает. Бэкап снимается, пока хостинг жив. Почтовые записи тоже. TTL опускается заранее. NS переключаются у регистратора, а не у хостера. Всё это пришлось делать в день аварии, а должно было лежать готовым.
Если у вас был похожий опыт с хостингом, или вы знаете, как сделать переключение DNS изящнее, пишите в комментариях. Обсудим.