В уроке про векторный поиск программа сравнивала вектор вопроса со всеми ста фрагментами текста. На миллионе фрагментов тот же способ потребует миллиона сравнений на каждый запрос. Если перебор занимает слишком много времени, поиск можно ускорить с помощью индекса.
Что делает векторная база
У векторной базы три задачи.
- Хранить векторы вместе с текстом, источником, датой и другими метаданными.
- Находить векторы, ближайшие к вектору запроса. Индекс помогает сделать это быстрее.
- Ограничивать поиск по метаданным. Например, искать похожие по смыслу фрагменты только в постах за 2026 год.
Как ускоряют поиск
Точный перебор считает расстояние от запроса до каждого вектора в базе. Приближённый поиск (ANN) использует индекс и сравнивает запрос только с частью векторов.
Один из таких индексов называется HNSW. В нём близкие векторы связаны между собой. На верхних уровнях точек мало, поэтому поиск быстро находит нужную область. Затем он спускается ниже и уточняет результат среди соседних точек.
Индекс может пропустить даже ближайший вектор. Чтобы измерить это, сравнивают выдачу индекса с точным перебором. Доля найденных ближайших векторов называется recall. Чем больше кандидатов проверяет индекс, тем выше обычно эта доля и тем дольше поиск. На построение индекса тоже уходит время, а для хранения нужно дополнительное место.
Три варианта
pgvector — расширение для PostgreSQL. Вектор можно хранить в той же таблице, что и текст. Запрос ниже возвращает три фрагмента, ближайшие к вектору запроса $1.
CREATE EXTENSION vector;
CREATE TABLE куски (id serial, текст text, v vector(1024));
SELECT текст FROM куски
ORDER BY v <=> $1   -- <=> это косинусное расстояние
LIMIT 3;
Если PostgreSQL уже есть, pgvector позволит обойтись одним сервером и общими резервными копиями. Данные из других таблиц можно подключать через JOIN. К pgvector я ещё вернусь в блоке про SQL.
Chroma можно использовать как библиотеку Python. Она работает внутри программы и может сохранять данные в локальную папку. Для прототипа отдельный сервер не понадобится.
Qdrant обычно запускают как отдельный сервис, например в Docker. Он умеет искать по векторам с фильтрами по метаданным. Его стоит рассмотреть, если векторов много и приложение часто выполняет такой поиск.
Что выбрать
- Если фрагментов несколько тысяч, начните с перебора в памяти и файла с векторами. Замерьте время ответа на типичных запросах.
- Если в прототипе нужно хранить векторы между запусками и искать по ним с фильтрами, попробуйте Chroma.
- Если данные уже лежат в PostgreSQL, попробуйте pgvector и проверьте скорость на своём объёме.
- Если поиск по векторам создаёт основную нагрузку, сравните pgvector с отдельным сервисом, например Qdrant.
Если даже точный перебор часто находит фрагменты мимо темы, проверьте, как вы нарезали документы и какой моделью получили эмбеддинги. Если результаты ухудшились после включения индекса, сравните его выдачу с перебором. В учебном проекте «Спроси Доктора Лексиума» около тысячи постов. Для начала я бы оставил перебор и замерил время поиска после нарезки.
При смене модели эмбеддингов пересчитайте векторы всех фрагментов, даже если размерность осталась прежней. Как мы видели в уроке 12, векторы разных моделей нельзя сравнивать напрямую. Сохраните исходный текст, чтобы было из чего получить новые векторы.
Пример: поиск по смыслу в блоге на WordPress
Допустим, читатель ищет «сайт не отправляет письма». Хочется показать ему статью про WP Mail SMTP, даже если в статье вопрос сформулирован иначе. Для этого можно сделать PHP-плагин с отдельной формой поиска. Сам WordPress модель эмбеддингов не запускает. В этом примере плагин обращается к внешнему API, а векторы хранит в той же базе, где лежат посты.
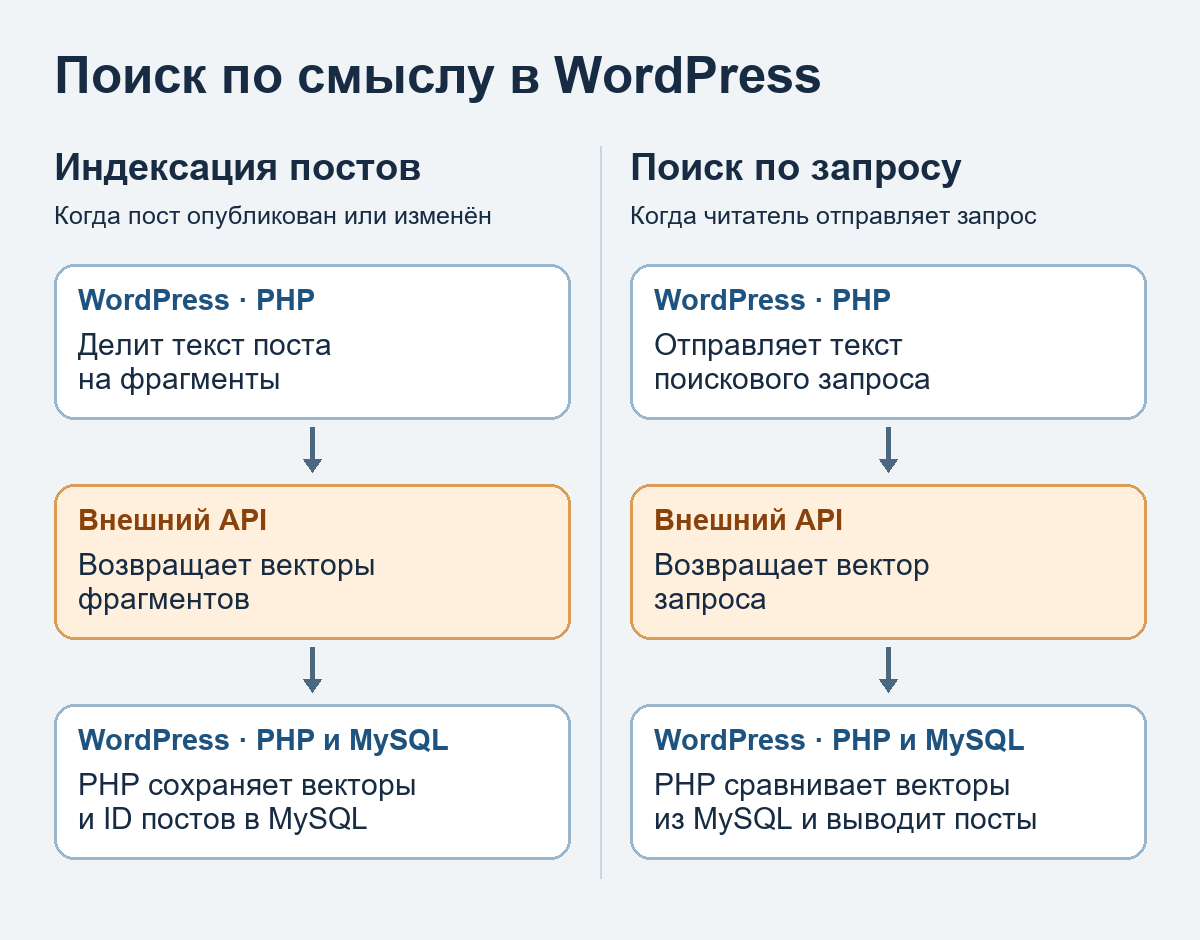
- При индексации. Плагин берёт заголовок и текст опубликованной записи, делит длинный текст на фрагменты и отправляет их во внешний API. Для каждого фрагмента сохраняет ID поста, текст и полученный вектор в отдельной таблице MySQL. После правки поста фрагменты пересчитываются в фоне. Если пост сняли с публикации, его фрагменты убираются из таблицы.
- При поиске. PHP отправляет «сайт не отправляет письма» тому же API и получает вектор запроса. Если сервис недоступен, плагин может показать результаты обычного поиска WordPress.
- При выдаче. PHP читает векторы из MySQL и для начала сравнивает их с вектором запроса простым перебором. По косинусному сходству выбирает ближайшие фрагменты. Если несколько фрагментов относятся к одной статье, показывает её один раз, с самым подходящим отрывком. Перед показом проверяет, что пост всё ещё опубликован.
Для первой проверки хватит отдельной формы и нескольких десятков постов. Сравните её выдачу со штатным поиском на одних и тех же запросах. Отдельно замерьте время вызова API и время перебора векторов. Если долго отвечает API, векторный индекс не ускорит этот шаг. Если основное время уходит на перебор, тогда есть смысл попробовать векторную базу.
Попробуйте сами
Если в векторе 1024 числа по 4 байта, он займёт 4096 байт. Сколько памяти понадобится на миллион фрагментов? А на ваши документы после нарезки? Если векторы помещаются в память, попробуйте перебор и замерьте время поиска.
Что запомнить
- База хранит векторы вместе с текстом и метаданными. По ним можно задать фильтр для поиска.
- HNSW ускоряет поиск, проверяя часть векторов. Из-за этого он может пропустить ближайший.
- Chroma можно запустить прямо в Python, pgvector работает внутри PostgreSQL, а Qdrant обычно запускают отдельно.
- На небольшом наборе сначала замерьте скорость точного перебора. По нему же можно проверить, сколько ближайших векторов находит индекс.
Проверьте себя
- Почему поиск с индексом HNSW называют приближённым?
- Когда pgvector выгоднее отдельной векторной базы?
- Вы сменили модель эмбеддингов. Что надо сделать с базой?
В следующем уроке соберём RAG от начала до конца. Найдём нужные фрагменты в документах и передадим их модели, чтобы она ответила со ссылками на источники.
Если остались вопросы, пишите в комментариях.