«Кот любит…» Что поставить дальше: «молоко», «спать» или «окно»? В первом уроке ответ был коротким: нейросеть считает. Теперь можно открыть эту коробку и повторить расчёт на бумаге.
Урок за 7 минут: как номера токенов превращаются в векторы, как сеть смешивает информацию и откуда берутся вероятности продолжений. Понадобятся только действия из урока 3 и калькулятор для последнего шага.
Наша маленькая учебная модель
У настоящей модели огромный словарь и много слоёв. Здесь оставим пять токенов и два числа на токен. Все веса придумаем сами, чтобы счёт помещался на странице. Эта модель не обучена и не умеет разговаривать.
В ней мы убрали часть устройства настоящего трансформера — распространённого вида языковой сети: обработку позиций, нормализацию чисел и другие детали. Оставили один механизм внимания и один небольшой блок вычислений. По этой схеме можно понять основные действия, но нельзя восстановить современную модель целиком.
| Номер токена | Кусочек текста | Вектор |
|---|---|---|
| 0 | Кот | [1, 0] |
| 1 | любит | [0, 1] |
| 2 | молоко | [1, 1] |
| 3 | спать | [0, 2] |
| 4 | окно | [−1, 0] |
Таблица векторов — таблица эмбеддингов. У каждой строки свой номер токена. В настоящей модели значения этой таблицы учатся вместе с остальными весами.
Пробелы в нашем словаре для краткости не показываем. Настоящий токенизатор учитывает их по своим правилам.
Шаг 1. От текста к таблице чисел
Токенизатор превращает «Кот любит» в номера [0, 1] по номерам строк в таблице эмбеддингов. По ним берём две строки таблицы:
Кот   → [1, 0]
любит → [0, 1]
Получилась матрица: две строки по два числа. Сеть работает с этими векторами, а не умножает номер «Кот» на номер «любит».
В настоящем трансформере учитывается ещё и порядок токенов. Иначе «Кот любит Машу» было бы трудно отличить от «Машу любит кот».
Шаг 2. Внимание: учесть оба слова
Мы продолжаем фразу «Кот любит». Для продолжения важно не только слово «любит», но и то, кто любит. Поэтому модели нужно соединить числа, относящиеся к этим двум словам.
Это делает внимание. Оно вычисляет, какую часть взять от каждого вектора, а затем складывает эти части.
В нашей учебной сети веса специально подобраны так, чтобы взять половину от «Кот» и половину от «любит». Это упрощение для понятного счёта. У обученной модели доли могут быть другими и зависеть от текста.
Наши векторы:
Кот:   [1, 0]
любит: [0, 1]
Берём половину каждого числа — то есть делим каждое число на 2:
От «Кот»:   [0,5; 0]
От «любит»: [0; 0,5]
Теперь складываем числа, стоящие на одинаковых местах:
Первое место: 0,5 + 0 = 0,5
Второе место: 0 + 0,5 = 0,5

Получили: [0,5; 0,5]
В новом списке есть вклад от обоих слов. Именно это здесь и делает внимание: собирает один список чисел из частей нескольких списков. Следующее слово пока не выбрано — до этого дойдём в шаге 5.
Осталось ещё одно действие. Мы обрабатываем позицию «любит». К результату внимания прибавим её исходный вектор, чтобы передать дальше и прежние числа, и результат обработки:
Результат внимания:      [0,5; 0,5]
Исходный вектор «любит»: [0;   1  ]

Сумма:                  [0,5; 1,5]
Такое прибавление называют остаточной связью. Список [0,5; 1,5] передаём в шаг 3.
Шаг 3. Ещё одно преобразование
После внимания в трансформере есть блок, который обрабатывает вектор каждой позиции отдельно. Обычно внутри — два умножения на матрицы и нелинейная функция между ними. Она меняет числа по правилу, которое нельзя заменить одним обычным умножением на матрицу.
У нашей сети обе матрицы сохраняют вход как есть. Между ними поставим простое правило ReLU: отрицательное число заменить нулём, положительное оставить. Например, [−2, 3] превратилось бы в [0, 3].
У нас оба числа положительные. Блок вернёт [0,5; 1,5]. Снова прибавим вход этого блока:
[0,5; 1,5] + [0,5; 1,5] = [1, 3]Векторы изменились. Итог [1, 3] теперь представляет последнюю позицию с учётом доступного ей контекста. Именно его используем для предсказания следующего токена. В большой модели подобные блоки повторяются много раз.
Шаг 4. Одна оценка для каждого токена
Нужна ещё одна таблица весов — выходная матрица. В ней по строке на каждый токен словаря. Это отдельная таблица нашей модели; она не обязана совпадать с таблицей входных эмбеддингов.
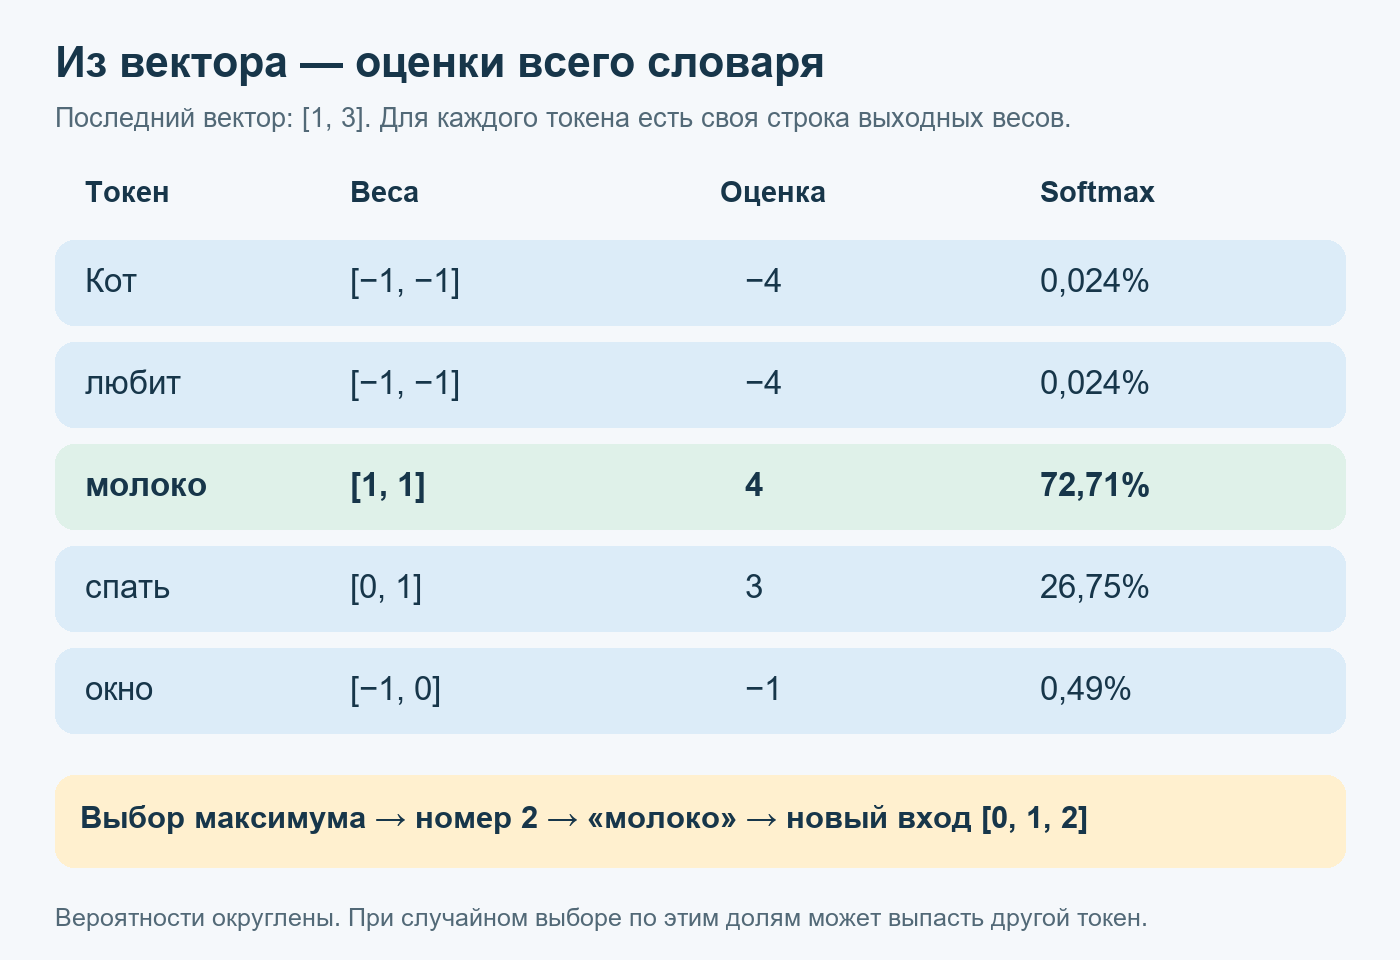
Умножаем итоговый вектор [1, 3] на веса каждой строки и складываем, как в прошлом уроке:
| Возможный следующий токен | Веса строки | Оценка |
|---|---|---|
| Кот | [−1, −1] | 1 × (−1) + 3 × (−1) = −4 |
| любит | [−1, −1] | −4 |
| молоко | [1, 1] | 1 × 1 + 3 × 1 = 4 |
| спать | [0, 1] | 1 × 0 + 3 × 1 = 3 |
| окно | [−1, 0] | 1 × (−1) + 3 × 0 = −1 |
Эти оценки называют логитами. Пока это пять обычных чисел, включая отрицательные.
Шаг 5. Вероятности и выбор
Теперь softmax. Для каждой оценки калькулятор считает exp(оценка) — это специальная функция, которая всегда даёт положительное число и растёт вместе с оценкой. Затем каждое полученное число делят на их общую сумму.
Оценки:       −4       −4       4       3       −1
После exp:    0,0183   0,0183   54,598  20,086  0,3679
Общая сумма: примерно 75,088

Для «молоко»: 54,598 / 75,088 ≈ 0,7271 ≈ 72,71%
Все числа округлены. Получается примерно: «молоко» — 72,71%, «спать» — 26,75%, «окно» — 0,49%, «Кот» и «любит» — по 0,024%. Вместе — около 100%.
Если программа всегда берёт самый вероятный вариант, получится «молоко». Если выбирает случайно по этим вероятностям, может получиться и «спать». Температуру и другие настройки выбора разберём в уроке 8.
Выбран номер 2? Программа берёт из словаря соответствующий кусочек «молоко», добавляет к тексту и получает [0, 1, 2]. Для продолжения снова выполняются вычисления. Большие системы умеют сохранять промежуточные результаты прошлых позиций, чтобы не пересчитывать всё с нуля.
На выходе сети сначала появляется список оценок всего словаря. Один токен выбирается уже из этого списка.
Попробуйте сами
Поменяйте строку выходных весов для «спать» с [0, 1] на [2, 1]. Какой станет оценка при том же векторе [1, 3]? Какой токен теперь победит при выборе наибольшей оценки?
Что запомнить
- Номера токенов выбирают векторы из таблицы. Слои сети преобразуют эти векторы.
- Внимание смешивает информацию из доступных позиций; матрицы и нелинейные функции обрабатывают числа дальше.
- Выходная матрица даёт оценку каждому токену. Softmax даёт вероятности, а программа выбирает продолжение.
Проверьте себя
- Почему токены с номерами 10 и 20 не обязаны быть похожими?
- Зачем нужна выходная матрица?
- Какой результат у задания про «спать»?
В следующем уроке — как сеть учится: кто и по какому правилу меняет веса этих таблиц.
Источники для углубления: статья об устройстве трансформера и учебный пример эмбеддингов и языковой модели PyTorch (на английском).