В прошлом уроке я писал, что языковая модель угадывает «следующий кусочек» текста. Схитрил: не сказал, что это за кусочки. Не буквы, но и не слова, а токены. От них зависит, сколько текста модель «помнит», почему она внезапно забывает начало разговора и сколько стоит ответ.
Токен — это кусочек слова
Модель не читает буквы: их слишком мало, каждая почти ничего не значит. Не читает и целые слова: их слишком много, особенно в русском с его падежами. Поэтому текст режут на кусочки среднего размера — токены. Частые слова целиком становятся одним токеном, редкие разбиваются на части.
Как резать, решают заранее, ещё до обучения: по огромному корпусу текстов составляют словарь из десятков тысяч самых полезных кусочков. Этот словарь и программу нарезки называют токенизатором. У каждой модели он свой.
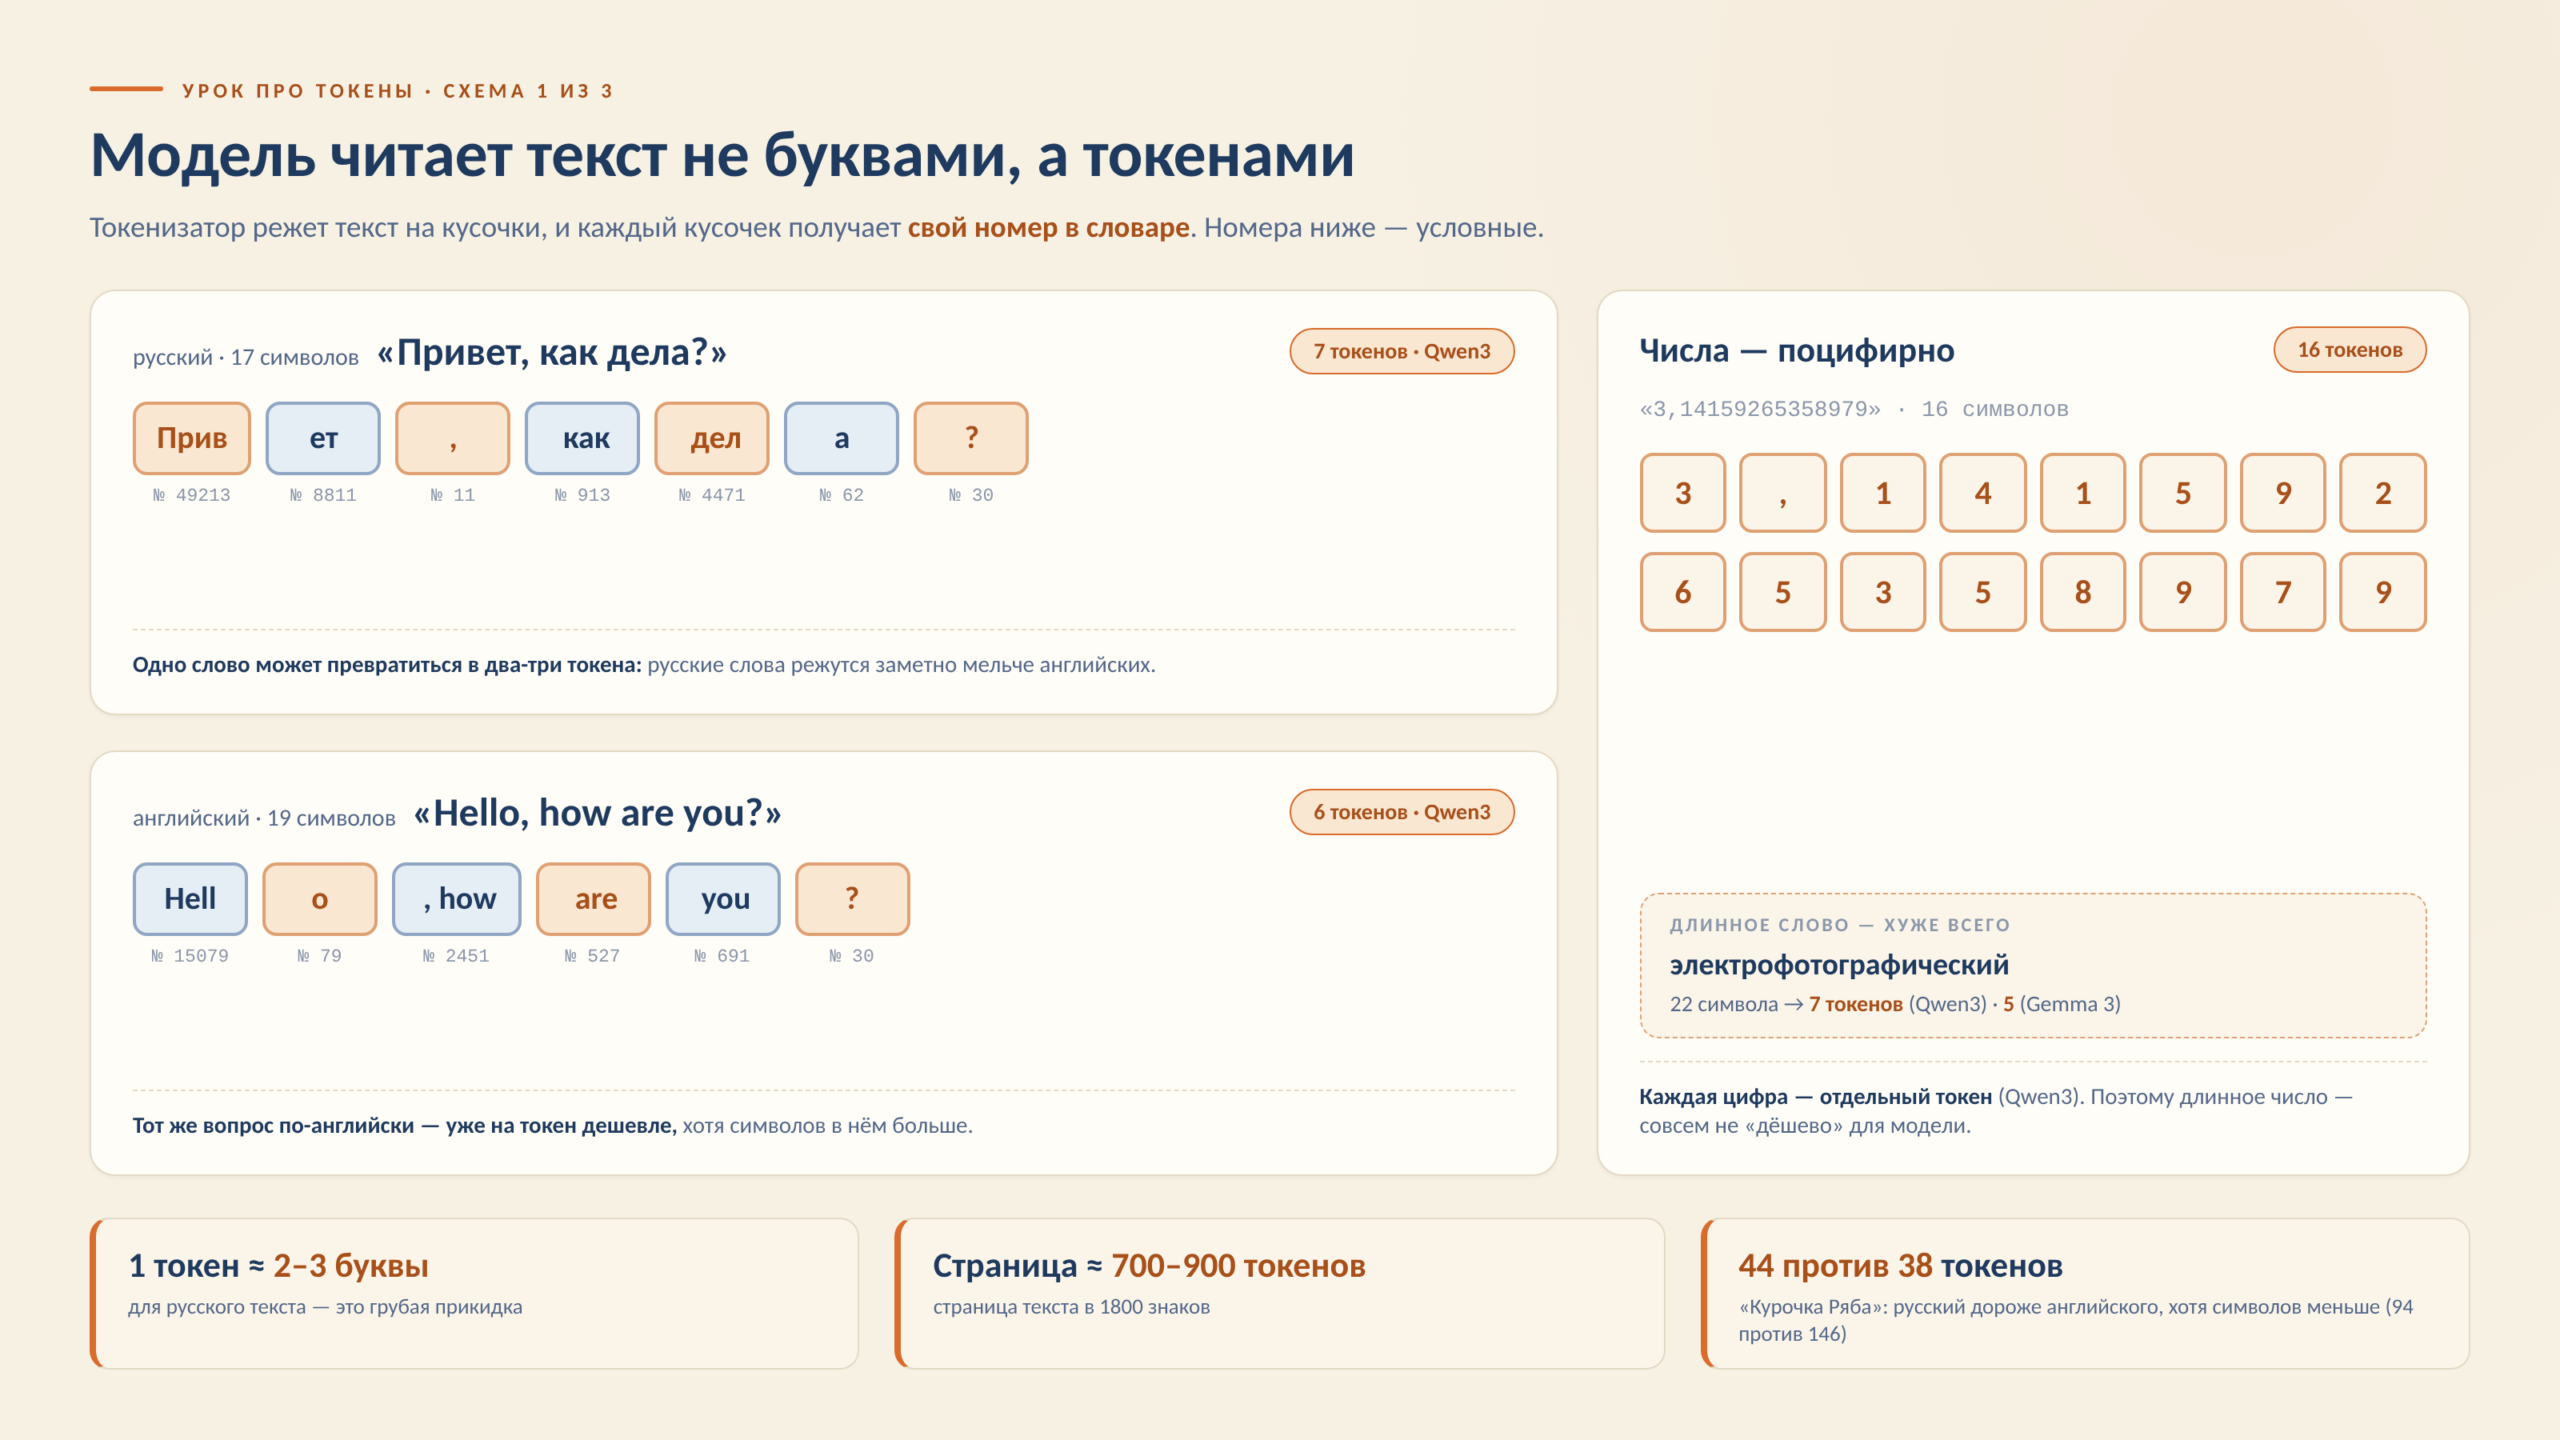
Внутри модели токен — просто номер в словаре. «Привет» для неё не слово, а, условно, число 49 213.
Сколько это в цифрах
Я прогнал несколько строк через две модели, которые стоят у меня дома (Qwen3 и Gemma 3, обе через Ollama):
| Текст | Символов | Токенов у Qwen3 | Токенов у Gemma 3 |
|---|---|---|---|
| «Привет, как дела?» | 17 | 7 | 7 |
| «Hello, how are you?» | 19 | 6 | 7 |
| Начало «Курочки Рябы» по-русски | 94 | 44 | 36 |
| То же по-английски | 146 | 38 | 39 |
| «электрофотографический» | 22 | 7 | 5 |
| «3,14159265358979» | 16 | 16 | 18 |
Что из этого видно:
- Русский дороже английского. У Qwen3 одна и та же сказка по-русски заняла 44 токена, а по-английски — 38, хотя английский текст на полтора раза длиннее в буквах. Токенизаторы учили в основном на английском, и русские слова режутся на кусочки мельче.
- Модели режут по-разному. Gemma 3 обошлась с русским текстом заметно экономнее Qwen3. Для русскоязычной работы это не мелочь: меньше токенов — больше влезает и дешевле обходится.
- Числа — поцифирно. Шестнадцать символов числа «пи» дали 16–18 токенов: каждая цифра отдельно. Отчасти поэтому модели бывают неуклюжи в арифметике: они видят не число, а цепочку цифр.
Грубая прикидка для русского текста: один токен — это 2–3 буквы. Стандартная страница (1800 знаков) — примерно 700–900 токенов.
Контекстное окно: память модели
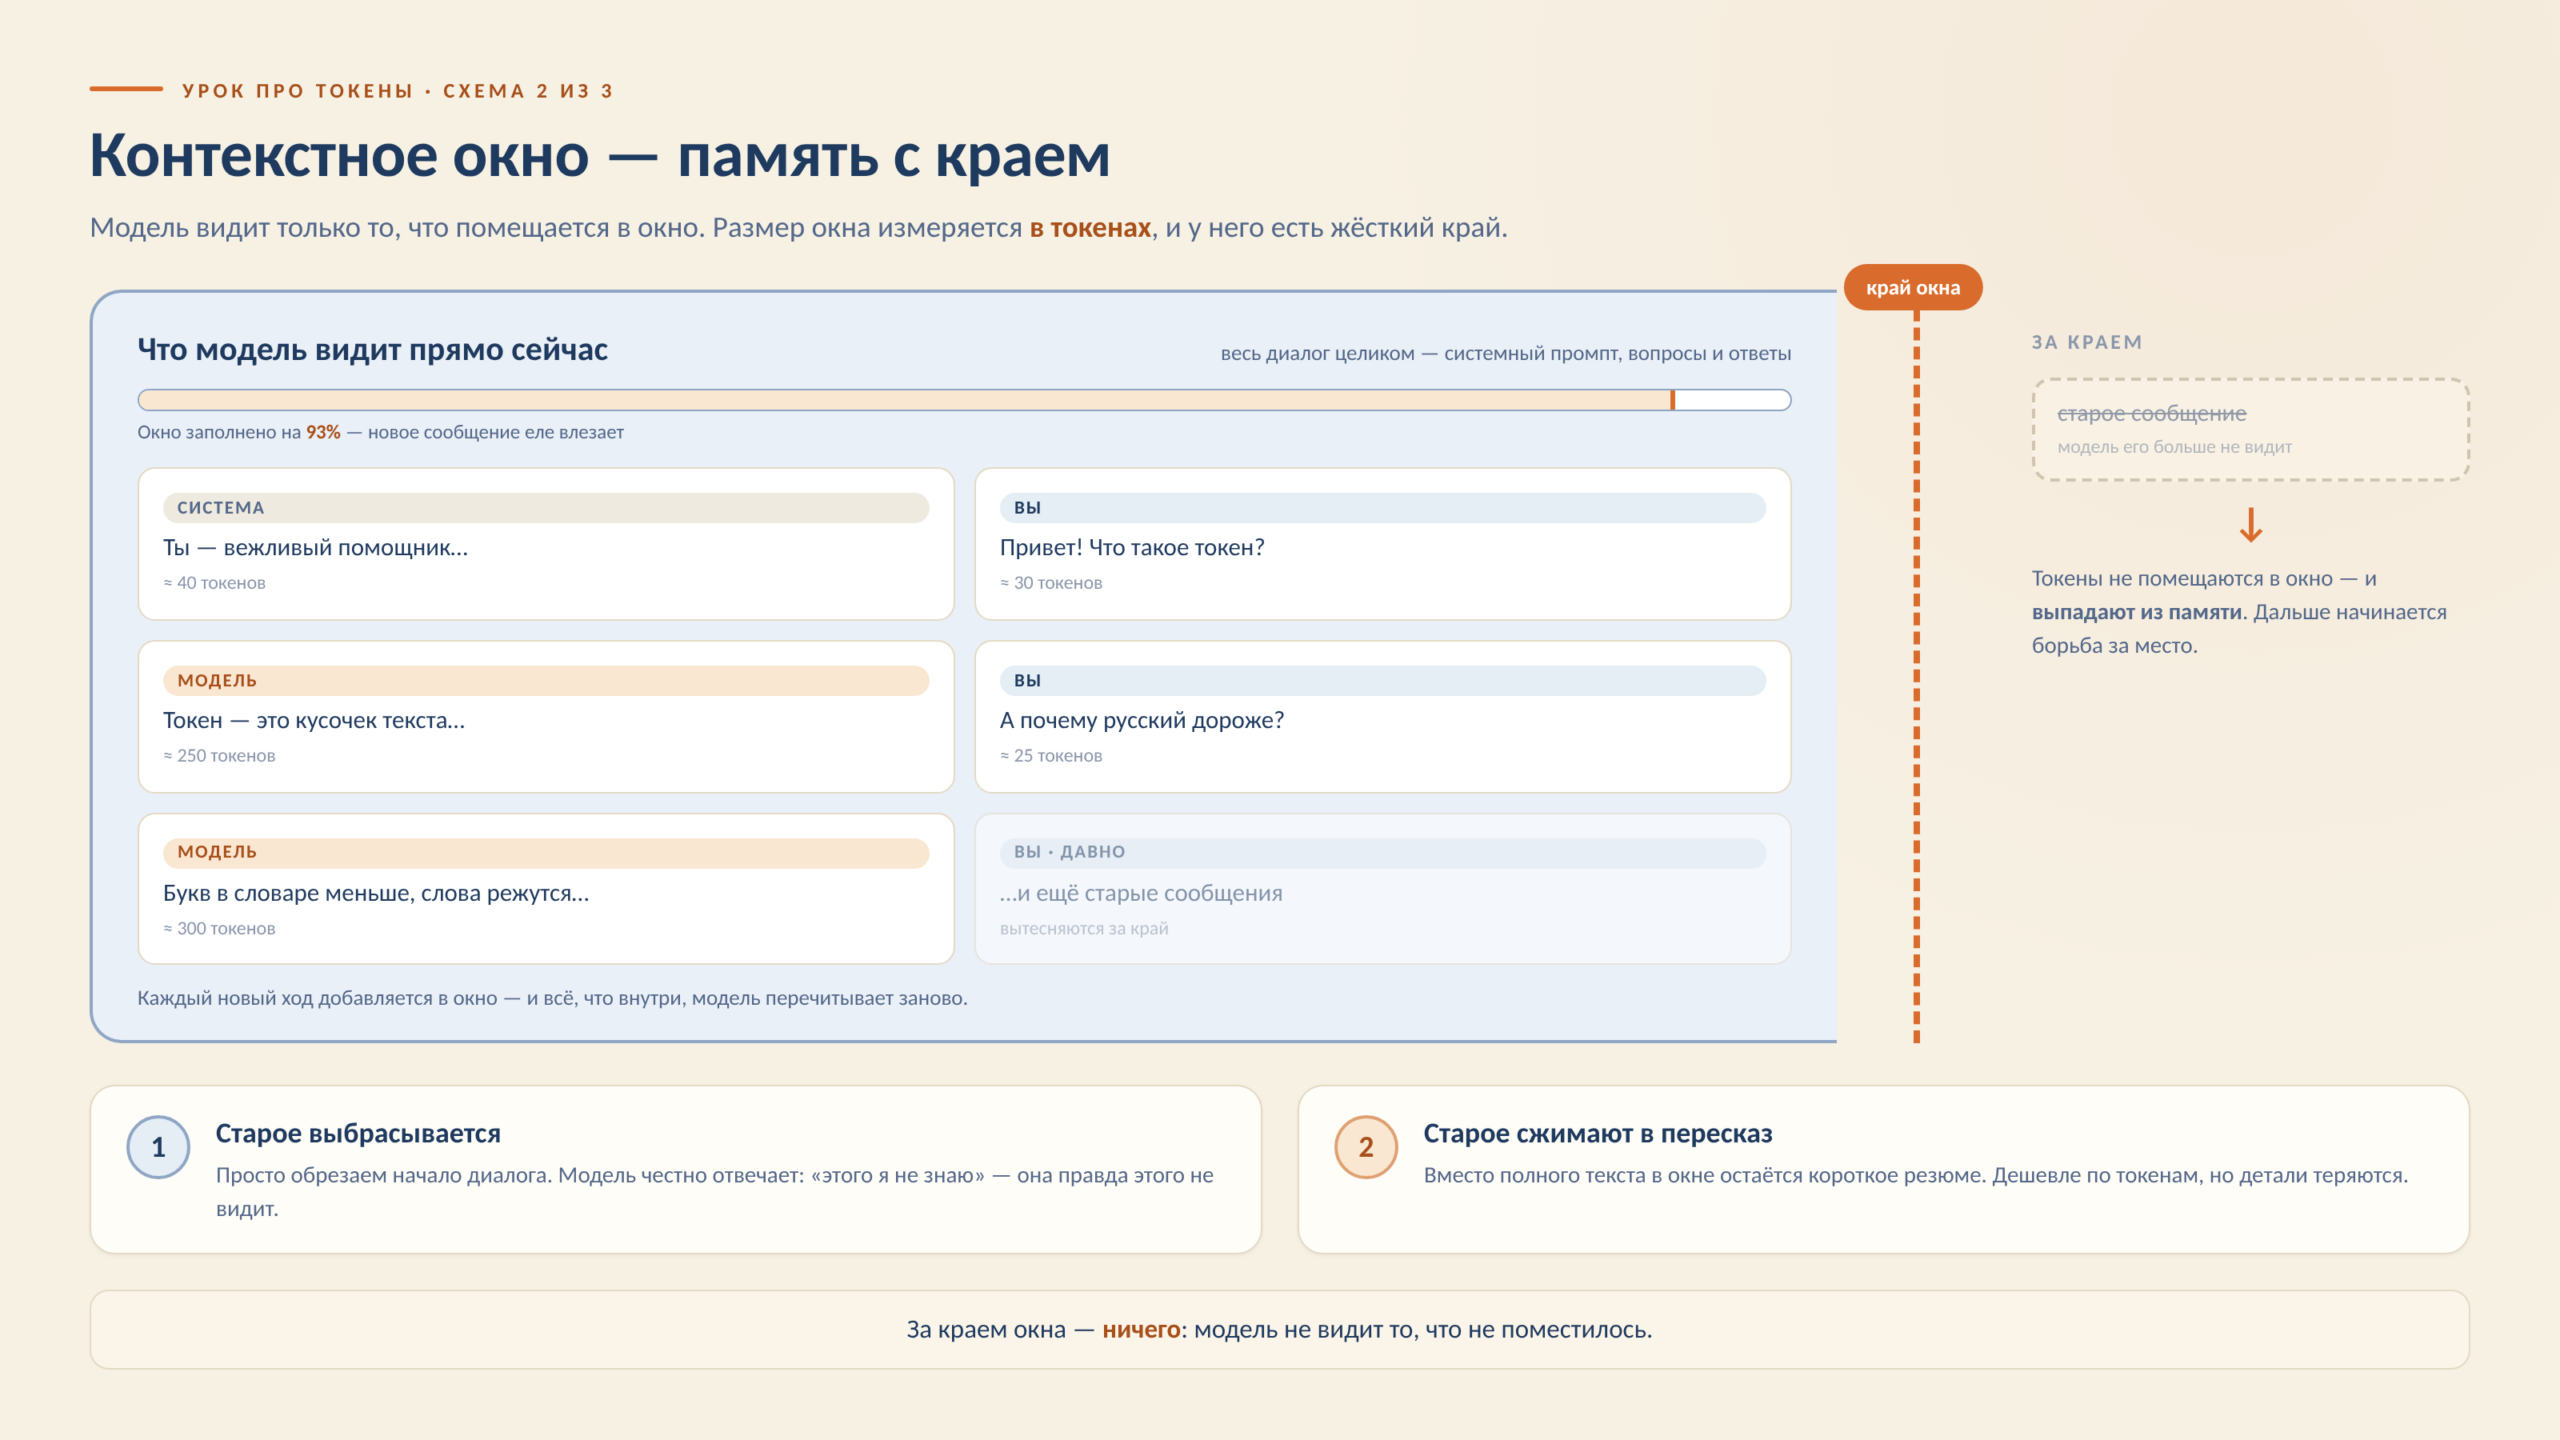
Модель не помнит прошлых разговоров. Всё, что она «знает» о текущей беседе, — это текст, который ей подают прямо сейчас: ваш вопрос, её прошлые ответы, приложенные файлы, скрытые инструкции. Вместе это называется контекстом, а предел его длины в токенах — контекстным окном.
Окна у современных моделей огромные: десятки и сотни тысяч токенов, у некоторых — миллион. Но у окна есть край. Что за краем — для модели не существует. Чат-программа поступает с этим одним из двух способов: молча выкидывает самое старое или заменяет его кратким пересказом.
Отсюда эффект «модель забыла, о чём мы договаривались вначале». Она не забыла — этого просто больше нет в её окне.
Я наблюдал это вживую. Пока мы с ИИ-агентом переделывали этот блог, работа шла весь день, и агент несколько раз упирался в край окна. Тогда старая часть разговора заменялась пересказом: решения сохранялись, а мелкие подробности пропадали. Поэтому важные договорённости агент записывает в отдельные файлы-заметки: они переживут любое сжатие.
Почему длинный чат дорожает
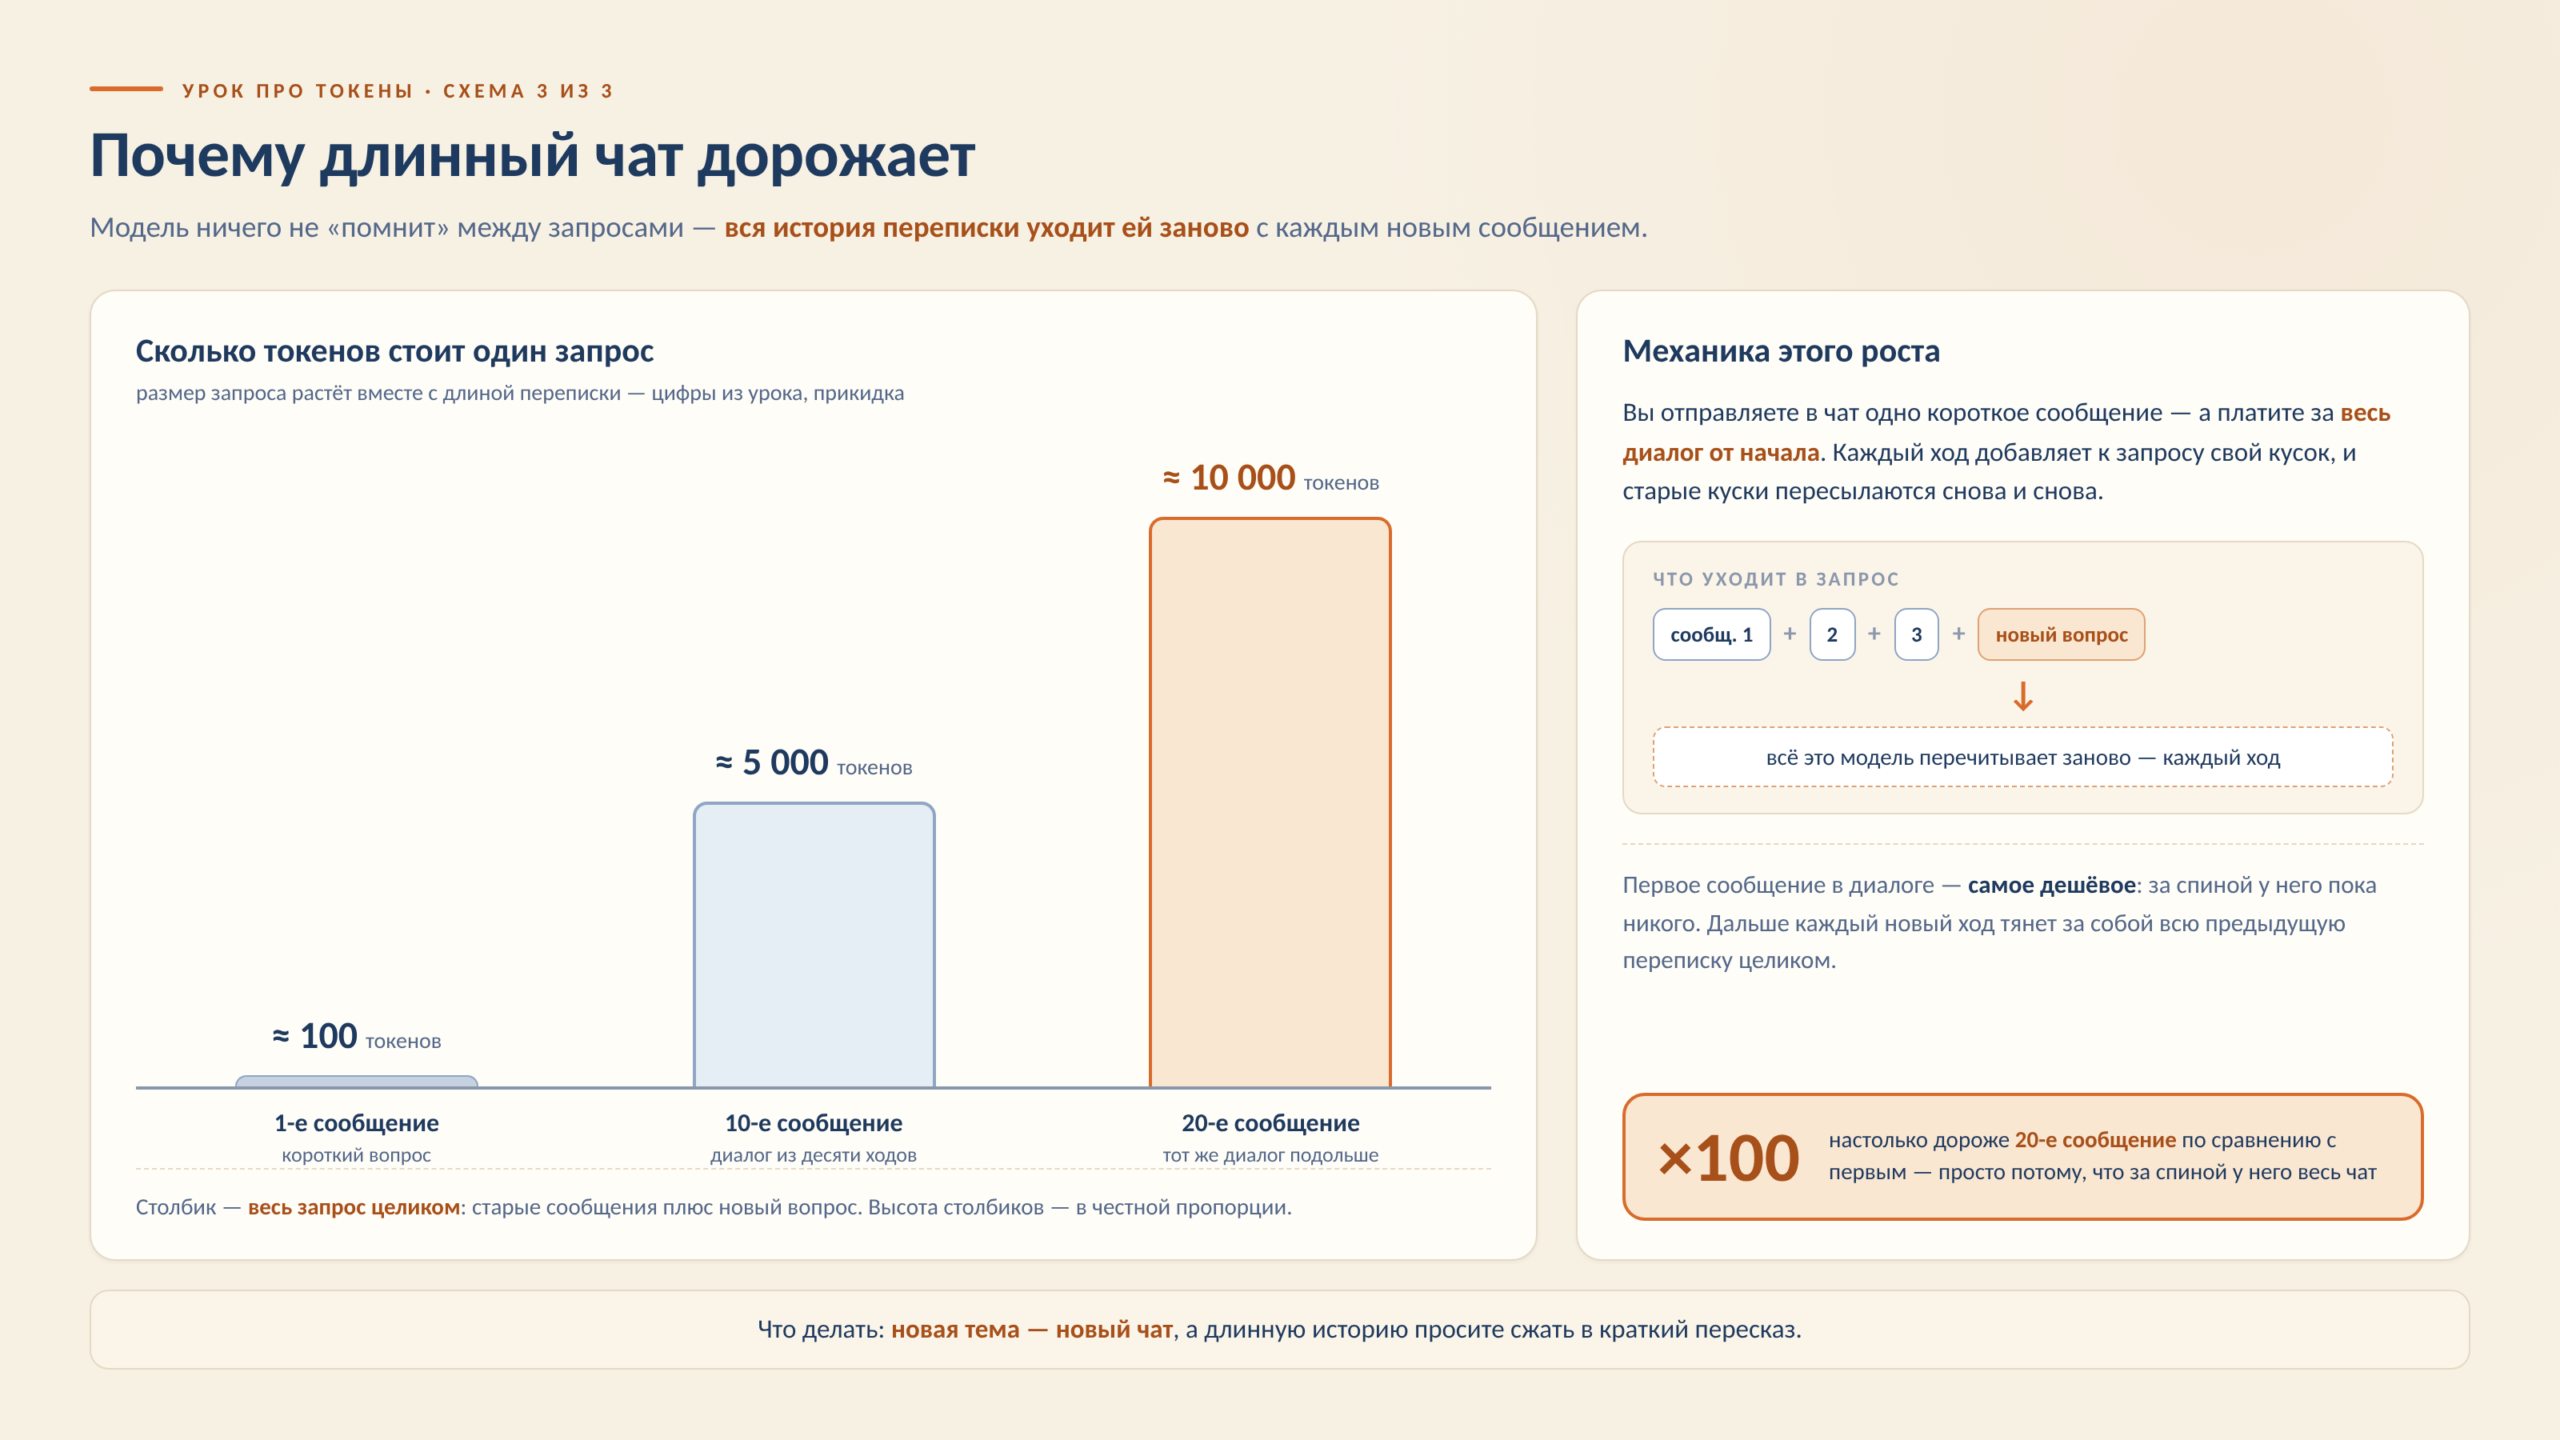
Модель не хранит разговор у себя. С каждым новым сообщением чат-программа отправляет ей всю историю заново — и платите вы (или ваш тариф) за все эти токены каждый раз.
Первое сообщение — 100 токенов. Десятое — уже, скажем, 5000: вся переписка плюс новый вопрос. Двадцатое — 10 000. Каждый следующий ответ дороже предыдущего, хотя вопрос такой же короткий.
Отсюда простые правила:
- Новая задача — новый чат. Хвост старого разговора не помогает, а стоит денег и сбивает модель.
- Не вставляйте файл целиком, если нужен один раздел.
- Платные API считают отдельно входные токены (то, что вы отправили) и выходные (что модель написала). Выходные обычно в несколько раз дороже.
Попробуйте сами
Откройте любой онлайн-токенизатор — например, токенизатор OpenAI, он работает без регистрации. Вставьте одно и то же предложение по-русски и по-английски и сравните число токенов. Потом вставьте длинное число или редкую фамилию и посмотрите, как их режет.
Если у вас стоит Ollama, точное число токенов показывает сама модель — поле prompt_eval_count в ответе:
curl http://localhost:11434/api/generate -d '{
  "model": "qwen3:4b",
  "prompt": "Привет, как дела?",
  "raw": true,
  "stream": false,
  "options": {"num_predict": 1}
}'
"raw": true отключает служебную обёртку чата, чтобы посчитать только ваш текст, а num_predict: 1 просит модель не тратить время на ответ.
Что запомнить
- Модель читает и пишет токенами — кусочками слов. Один токен в русском — примерно 2–3 буквы.
- Русский обычно дороже английского по токенам, и у разных моделей по-разному.
- Контекстное окно — вся «память» модели в текущем разговоре. Что за его краем, того для неё нет.
- В чате каждое сообщение отправляет всю историю заново, поэтому длинные разговоры дорожают. Новая задача — новый чат.
Проверьте себя
- Почему одна и та же фраза по-русски обычно занимает больше токенов, чем по-английски?
- Модель «забыла» условие, которое вы дали в начале длинного разговора. Что на самом деле произошло?
- Вы задали в одном чате 30 коротких вопросов подряд. Почему тридцатый ответ обошёлся дороже первого?
В следующем уроке — галлюцинации: почему модель уверенно сочиняет несуществующие факты и как это ловить.


