В прошлом уроке мы сами придумали веса маленькой сети. Поэтому «молоко» выиграло у «окно» по нашему решению. Настоящей модели не выписывают вручную миллиарды таких чисел. Их постепенно подбирает программа обучения. Но откуда она знает, какое число увеличить, а какое уменьшить?
Урок за 6 минут: учебный пример, величина ошибки, наклон, шаг обучения и обратное распространение. Сначала поменяем один вес на бумаге, потом вернёмся к языковой модели.
Откуда берётся правильный ответ
Возьмём фразу из учебного текста: «Кот любит молоко». Модели дают начало «Кот любит», а следующий токен «молоко» становится правильным ответом для этого задания. Ответ уже есть в тексте. Человек не обязан подписывать каждую такую пару вручную.
Из длинных текстов получают много подобных заданий. При обучении можно проверять предсказания сразу на многих позициях, закрывая от каждой позиции будущее продолжение. Это не тот же режим, что выдача ответа пользователю по одному токену.
Важно не только угадать
В нашей учебной модели вероятность «молоко» получилась примерно 73%. Если бы она была 90%, модель лучше предсказала бы этот конкретный пример. Если 1% — хуже. Даже когда правильный токен самый вероятный, качество предсказания ещё можно улучшить.
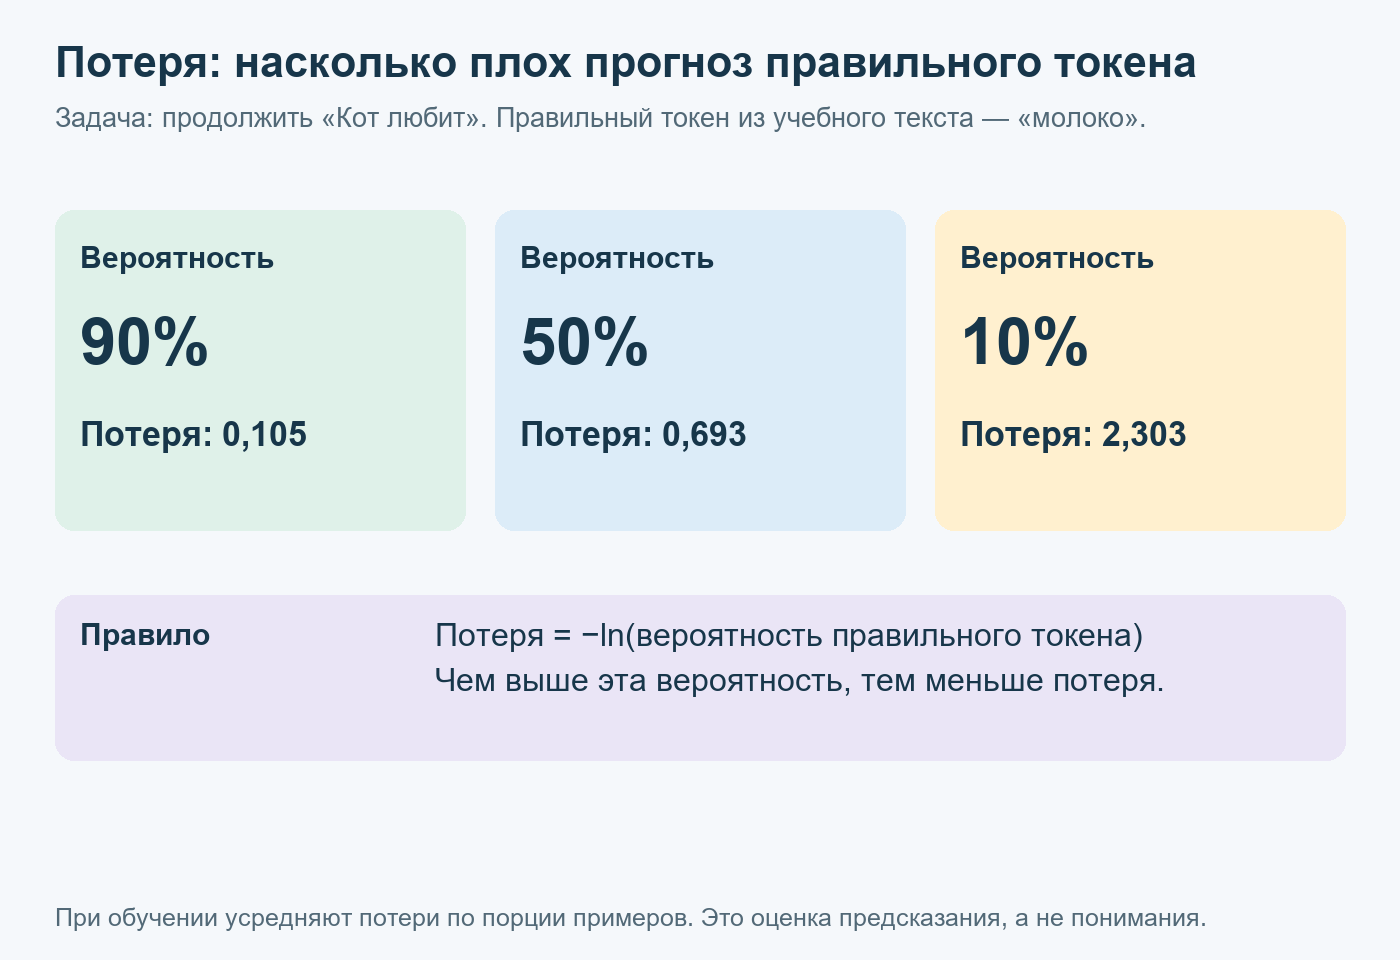
Для оценки используют функцию потерь. Это правило, которое превращает результат модели и правильный ответ в одно число: насколько плохо получилось.
При обычном обучении языковой модели потеря для одного правильного токена считается как −ln(p), где p — присвоенная ему вероятность. ln — функция калькулятора, натуральный логарифм. Сейчас её не нужно уметь вычислять вручную. Достаточно увидеть, как меняется результат:
| Вероятность правильного токена | Потеря, примерно |
|---|---|
| 90% = 0,9 | 0,105 |
| 50% = 0,5 | 0,693 |
| 10% = 0,1 | 2,303 |
Чем выше вероятность правильного токена, тем меньше потеря. По порции учебных примеров берут среднее значение потерь. Программа старается уменьшить именно его. Она не оценивает смысл текста как человек.
Один вес: пример без логарифмов
Чтобы понять изменение веса, временно возьмём формулу проще языковой сети:
Ответ = вход × вес
Вход = 2
Правильный ответ = 6
Начальный вес = 1
Формула выдаст 2 × 1 = 2. Возьмём для неё простую функцию потерь: разницу с правильным ответом умножить саму на себя. Это квадрат ошибки:
Потеря = (ответ − 6) × (ответ − 6)
При весе 1: (2 − 6) × (2 − 6) = 16
В этом маленьком примере потеря — квадрат ошибки, а у языковой модели выше — отрицательный логарифм вероятности. Правило оценки выбирают под задачу. Общий принцип обучения одинаков: посчитать потерю и найти, как её уменьшить.
В какую сторону двигать вес
Попробуем чуть увеличить вес:
| Вес | Ответ | Потеря |
|---|---|---|
| 0,99 | 1,98 | 16,1604 |
| 1,00 | 2,00 | 16,0000 |
| 1,01 | 2,02 | 15,8404 |
Вес растёт — потеря поблизости уменьшается. Значит, сейчас полезно двигаться вправо, к большему весу.
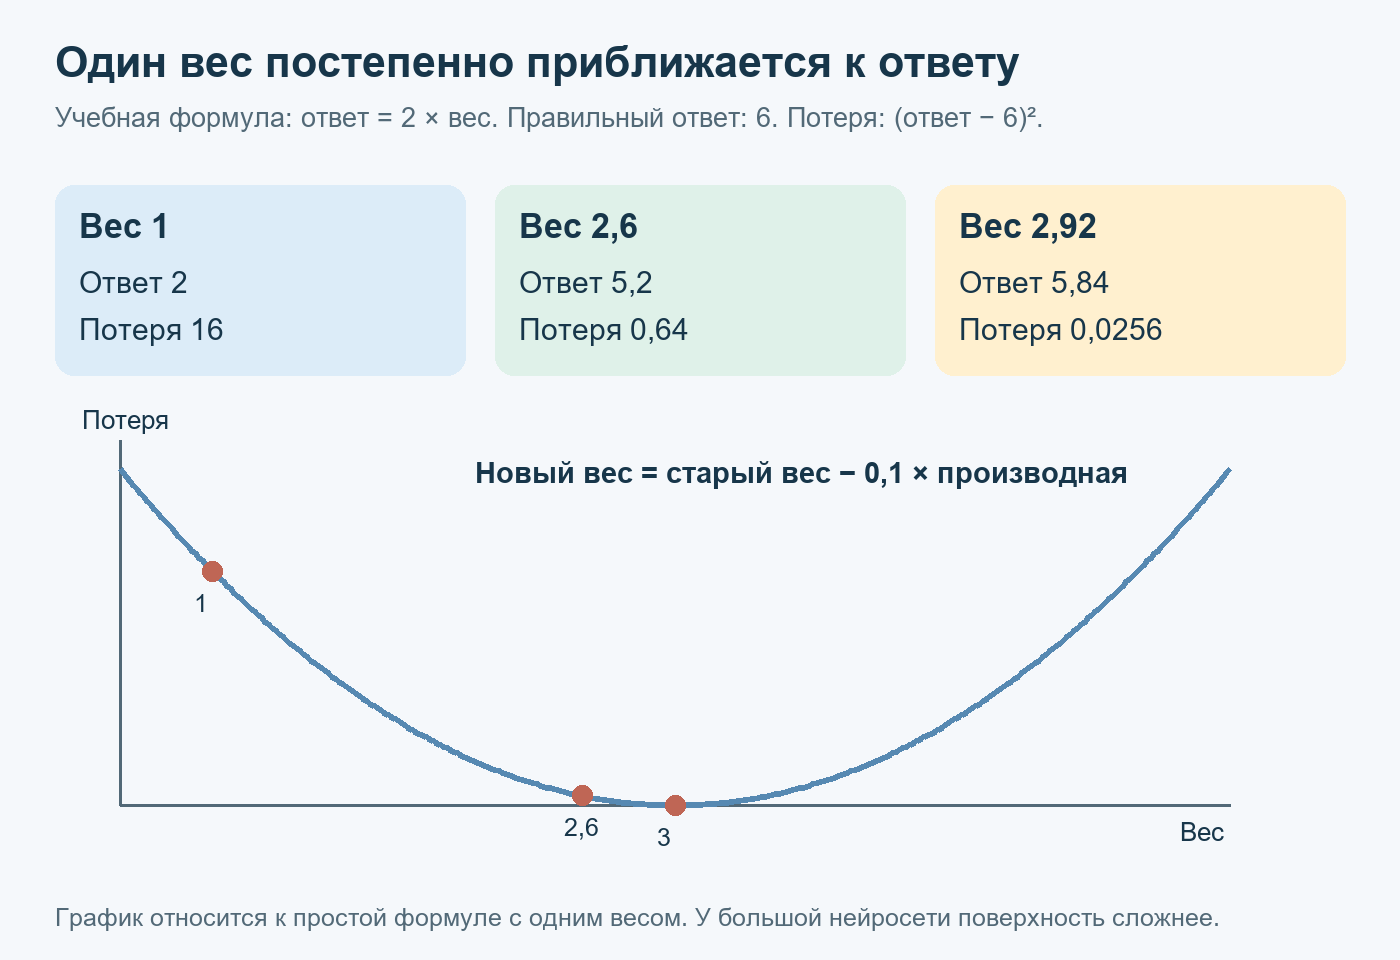
Представьте график: по горизонтали вес, по вертикали потеря. Мы стоим на склоне чаши. Производная показывает наклон в нашей точке: как быстро и в какую сторону меняется потеря при маленьком увеличении веса.
По соседним значениям наклон можно оценить так:
(15,8404 − 16,1604) / (1,01 − 0,99) = −16Минус означает, что при увеличении веса потеря здесь падает. Для нашей формулы точная производная в этой точке тоже равна −16. Все производные по всем весам вместе называют градиентом. Если вес один, в градиенте всего одно число.
На сколько менять вес
В простейшем способе обучения действует правило:
Новый вес = старый вес − размер шага × производнаяРазмер шага называют скоростью обучения. Возьмём 0,1:
Новый вес = 1 − 0,1 × (−16) = 2,6
Новый ответ = 2 × 2,6 = 5,2
Новая потеря = (5,2 − 6) × (5,2 − 6) = 0,64
Было 16, стало 0,64. Мы приблизились к правильному ответу. Затем заново считаем производную: при весе 2,6 она уже −3,2. Следующий вес — 2,92, ответ — 5,84, потеря — 0,0256. Продолжая, подойдём к весу 3.
Если шаг слишком большой, можно перескочить через дно чаши и даже увеличить потерю. Например, с шагом 1 первый вес стал бы 17, ответ — 34, а потеря — 784. Поэтому скорость обучения важна.
А если весов миллиарды?
Проверять каждый вес пробным изменением слишком долго. Вместо этого используют обратное распространение: способ вычислить производные, проходя цепочку операций от потери назад к весам.
Возьмём цепочку попроще: вход → умножение на вес → ответ → потеря. Маленькое изменение веса сначала меняет ответ, а через него — потерю. В нашем примере ответ меняется в 2 раза быстрее веса, потому что вход равен 2. При ответе 2 наклон квадрата ошибки по ответу равен −8. Перемножаем чувствительности двух звеньев: 2 × (−8) = −16. Получилась знакомая производная по весу.
В большой сети цепочка длиннее, а путей много. Программа перемножает чувствительности вдоль каждого пути и складывает вклады там, где пути сходятся. Так получают производные для весов ранних слоёв, внимания, эмбеддингов и выходной матрицы.
Затем оптимизатор — алгоритм обновления весов — делает шаг. Простейший вариант мы только что посчитали; он называется градиентным спуском. Более сложные оптимизаторы дополнительно учитывают историю прошлых шагов.
Обратное распространение вычисляет производные. Оптимизатор меняет веса. Это две разные части обучения.
Возвращаемся к словам
Для «Кот любит молоко» сеть выдаёт вероятности, функция потерь оценивает вероятность «молоко», обратное распространение вычисляет градиент, оптимизатор обновляет веса. Потом берут следующую порцию примеров.
Один шаг не обязан улучшать каждый текст. Примеры бывают разными и противоречивыми. Поэтому кроме учебных данных нужны проверочные данные, на которых веса не меняют. Они помогают понять, научилась ли модель работать с новыми примерами или в основном запомнила учебные.
При обычном разговоре веса, как правило, не меняются. Новый факт в чате попадает в контекст, а обучение весов — отдельный процесс. Дообучение на диалогах тоже меняет веса, но уже на специально подобранных примерах общения.
Попробуйте сами
В нашей простой формуле поставьте вес 4. Ответ будет 8, потеря — 4, производная по весу — +8. Сделайте шаг со скоростью 0,1. Вес должен увеличиться или уменьшиться? Посчитайте новый ответ и потерю.
Что запомнить
- Функция потерь превращает качество предсказания в число, которое стараются уменьшить.
- Градиент показывает наклон потери по каждому весу. Оптимизатор использует его, чтобы обновить веса.
- Обратное распространение вычисляет градиент через всю цепочку операций. Это не случайное подкручивание ручек.
Проверьте себя
- Откуда при обучении на тексте берётся правильный следующий токен?
- Что делает обратное распространение, а что оптимизатор?
- Какой результат у задания с весом 4?
В следующем уроке — галлюцинации: почему хорошо обученная модель всё равно может уверенно сочинять.
Для углубления: прямой проход, обратное распространение и вычислительные графы и градиентный спуск с графиками (на английском).